河本ラボ 研究論文DB
河本研究室の研究論文を一元管理するNotionデータベースです。
研究室内で共有して使うNotion DB。
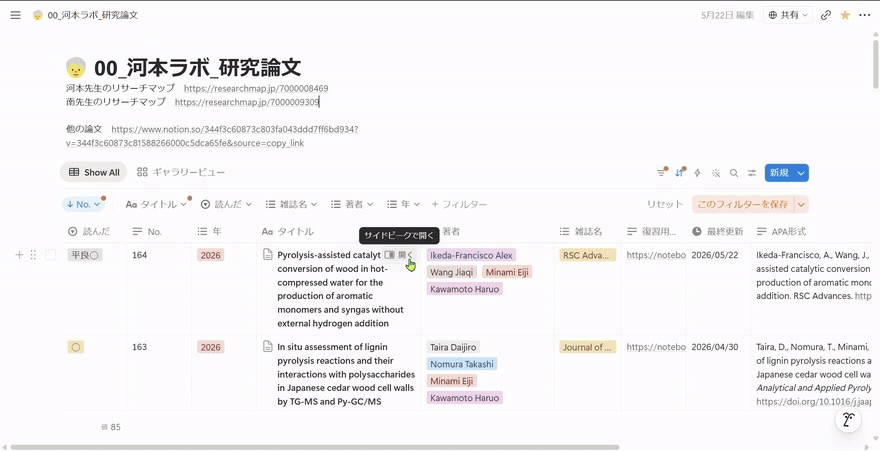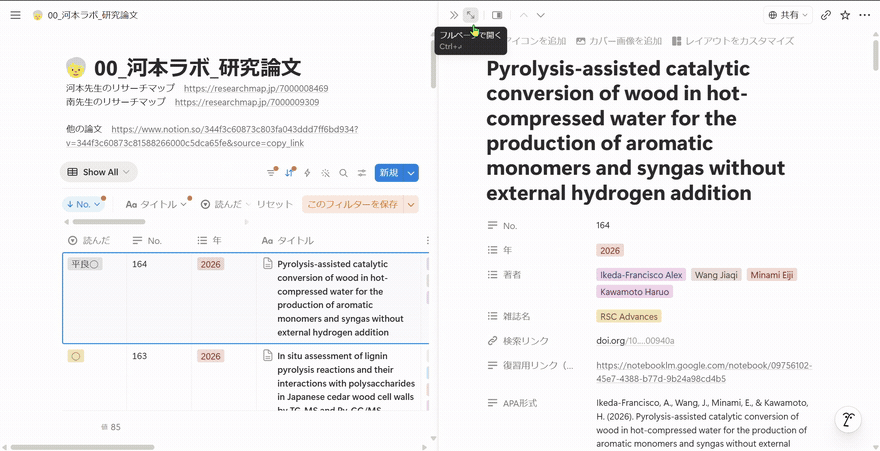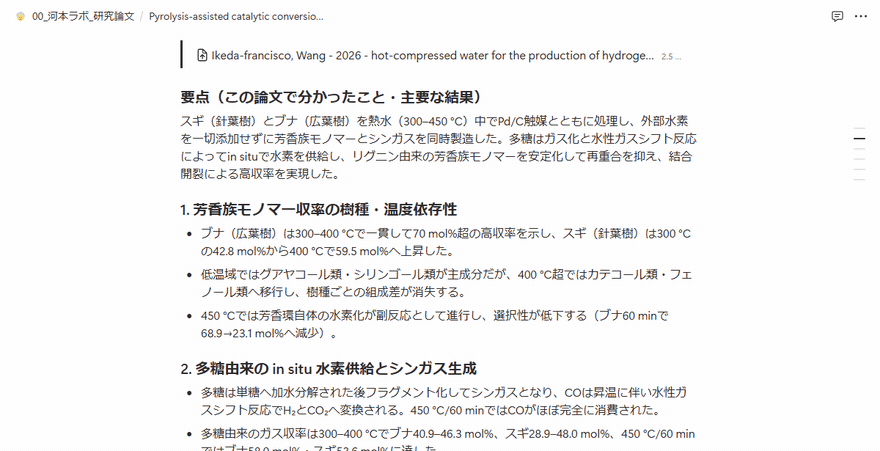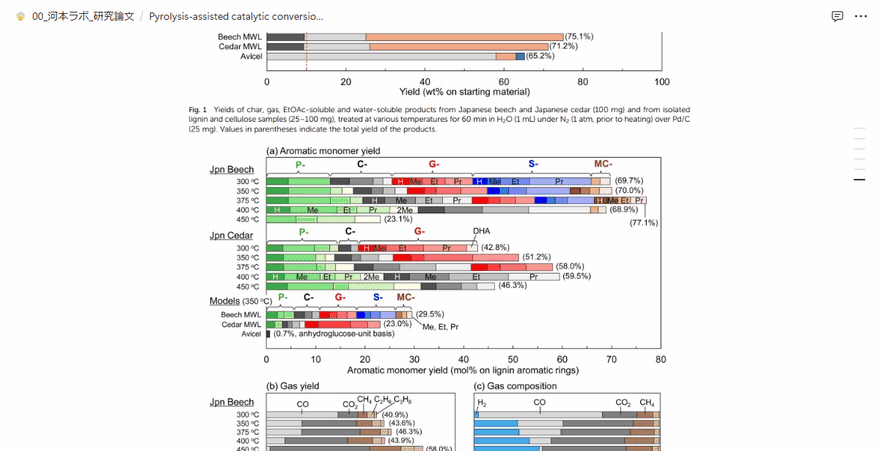
全164件(2026年時点)を著者・年・雑誌名で絞り込んで探せて、論文を開くと DOI・PDF(本体)・APA形式の引用に加えて、AIで作った『要点』『新規性』のまとめと図表まで1ページで読めます。各論文には復習用のNotebookLMリンクが付いていて、AIがスライド・マインドマップ・クイズまで作ってくれます。
使い方
-
画面の見方(一覧から探して開く)
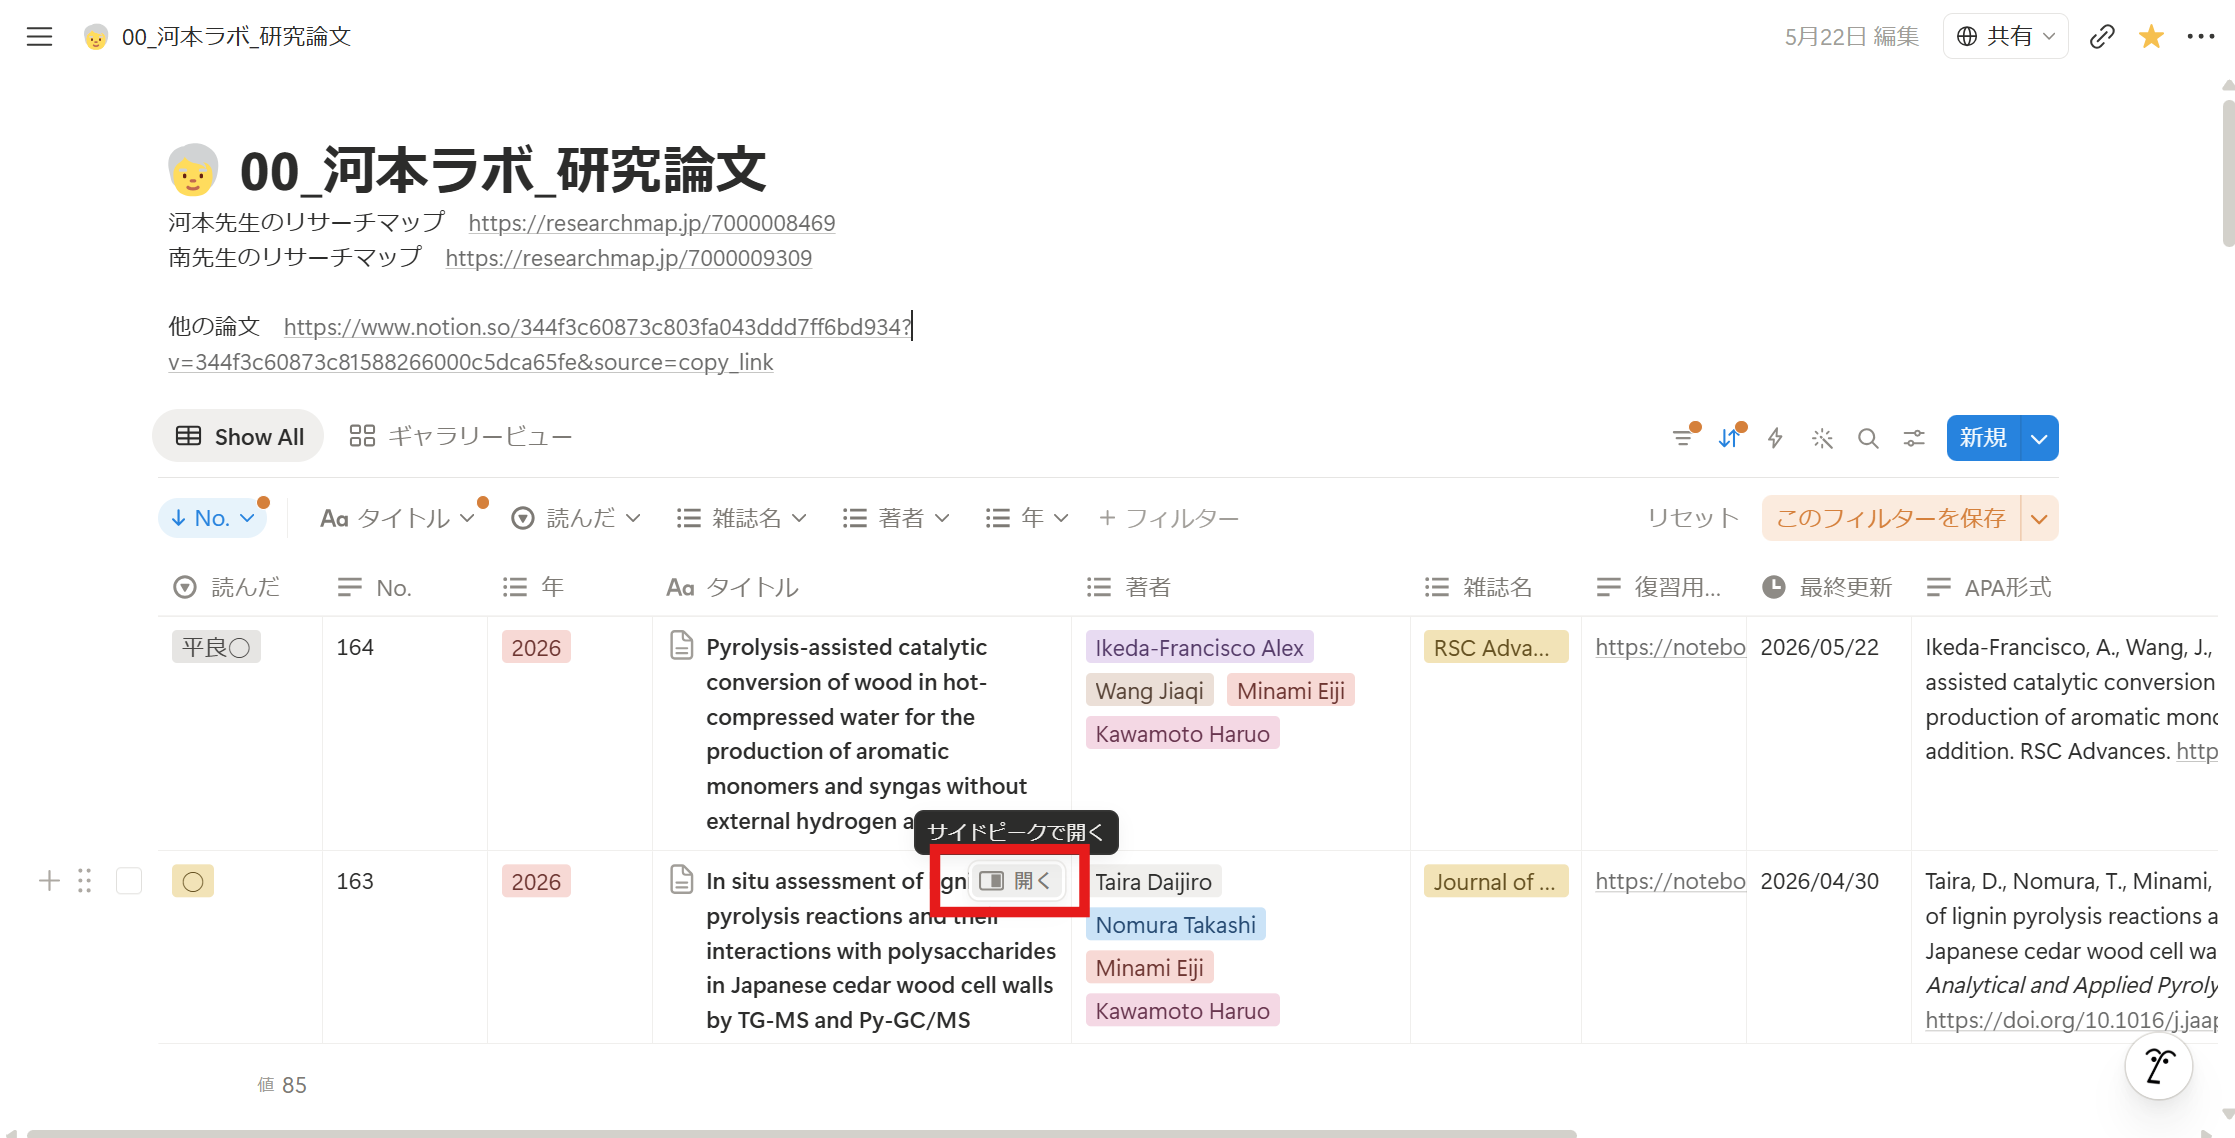
トップは全論文の一覧(テーブル)。最上段が最新で、ここでは No.164・2026年。各行のタイトルにマウスを置くと出る『開く』(赤枠)で、その論文のページへ。
-
絞り込み・並べ替えバーの場所
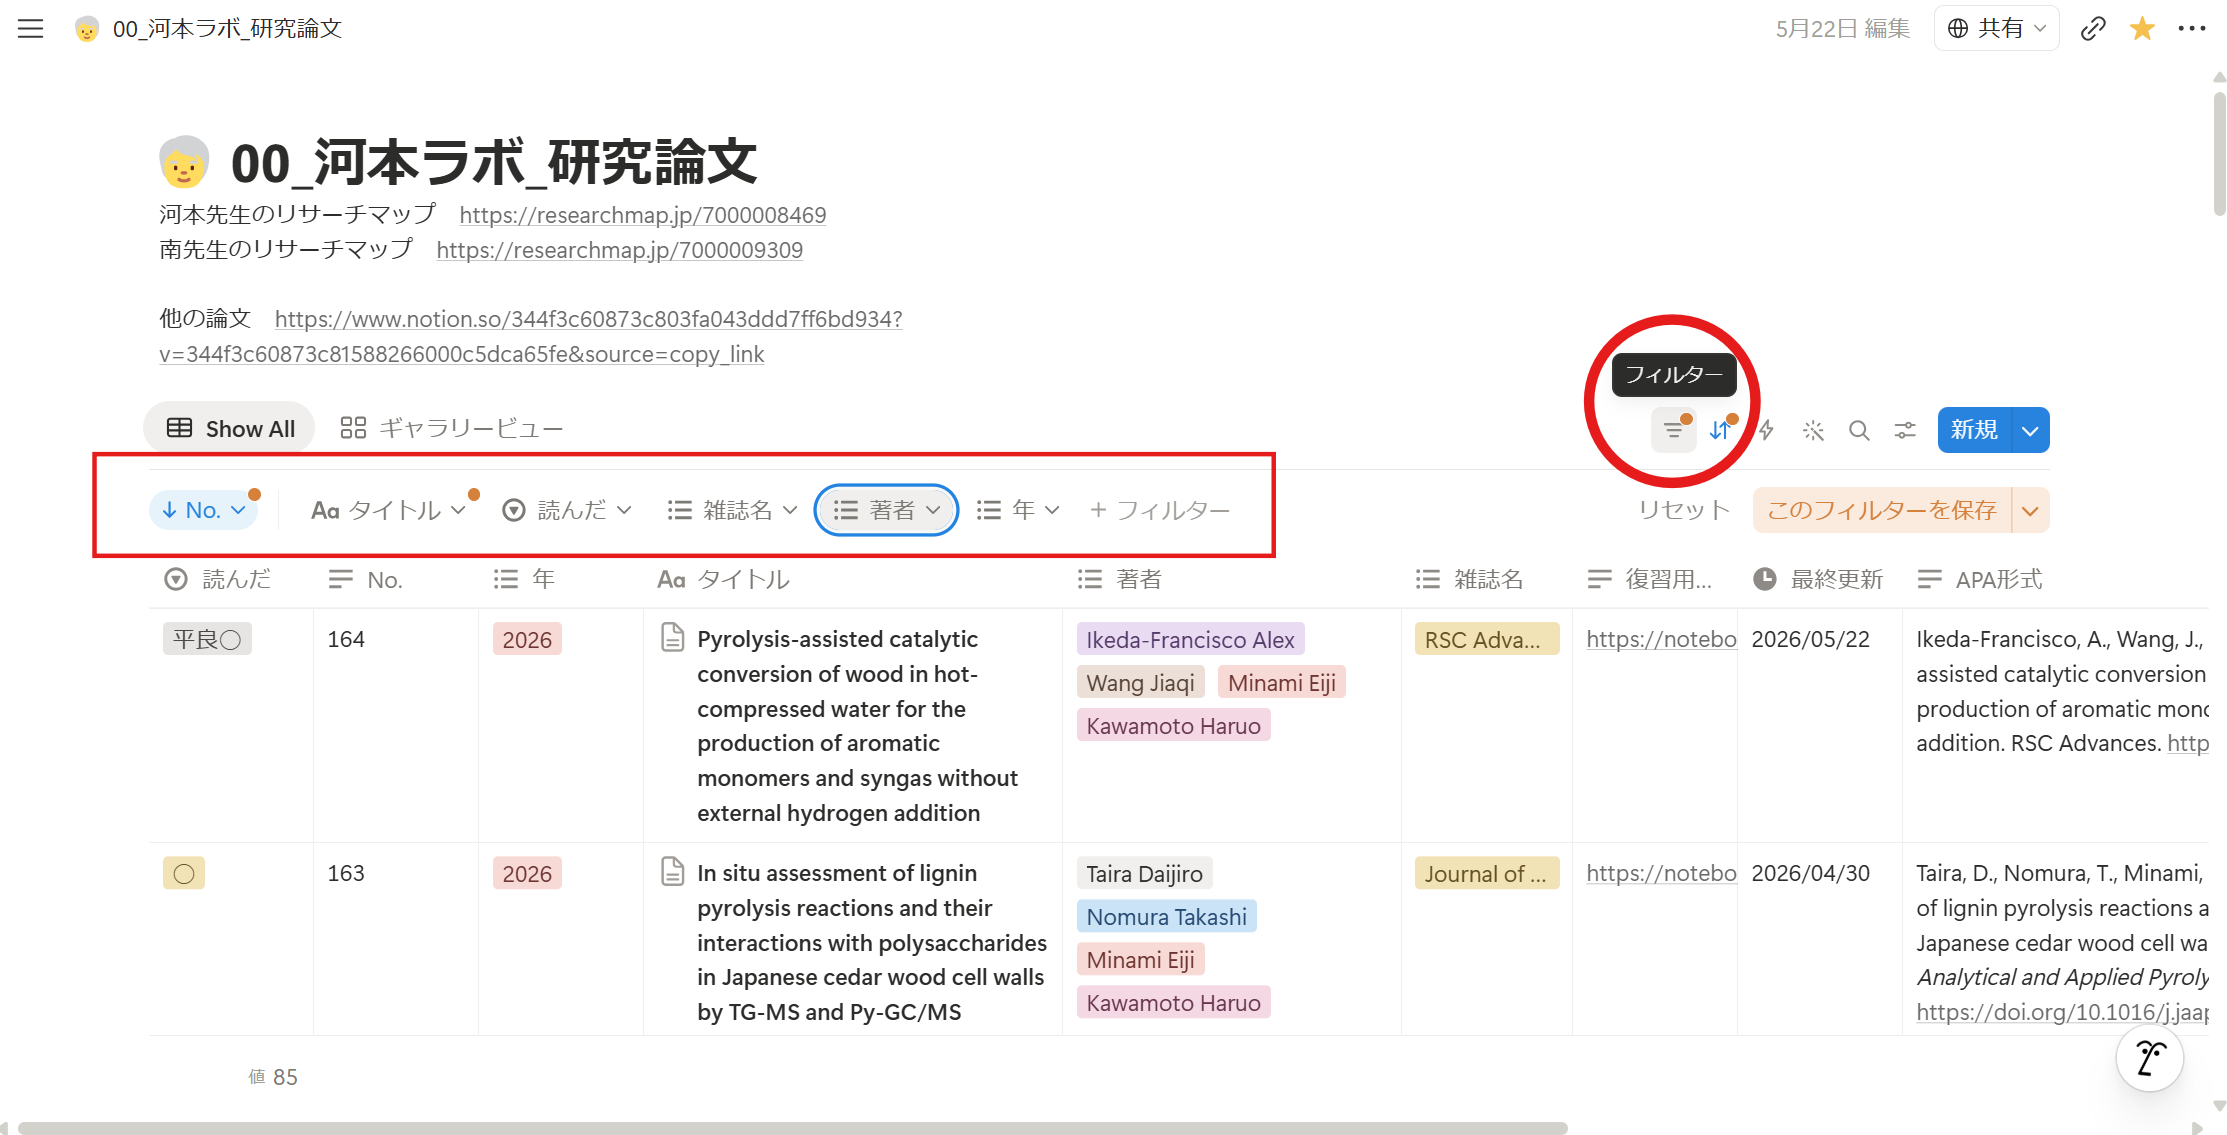
絞り込みと並べ替えは一覧の上部バーから。No./タイトル/読んだ/雑誌名/著者/年の各ボタンと、右上の『フィルター』(赤枠)が入口です。
-
著者で絞り込む
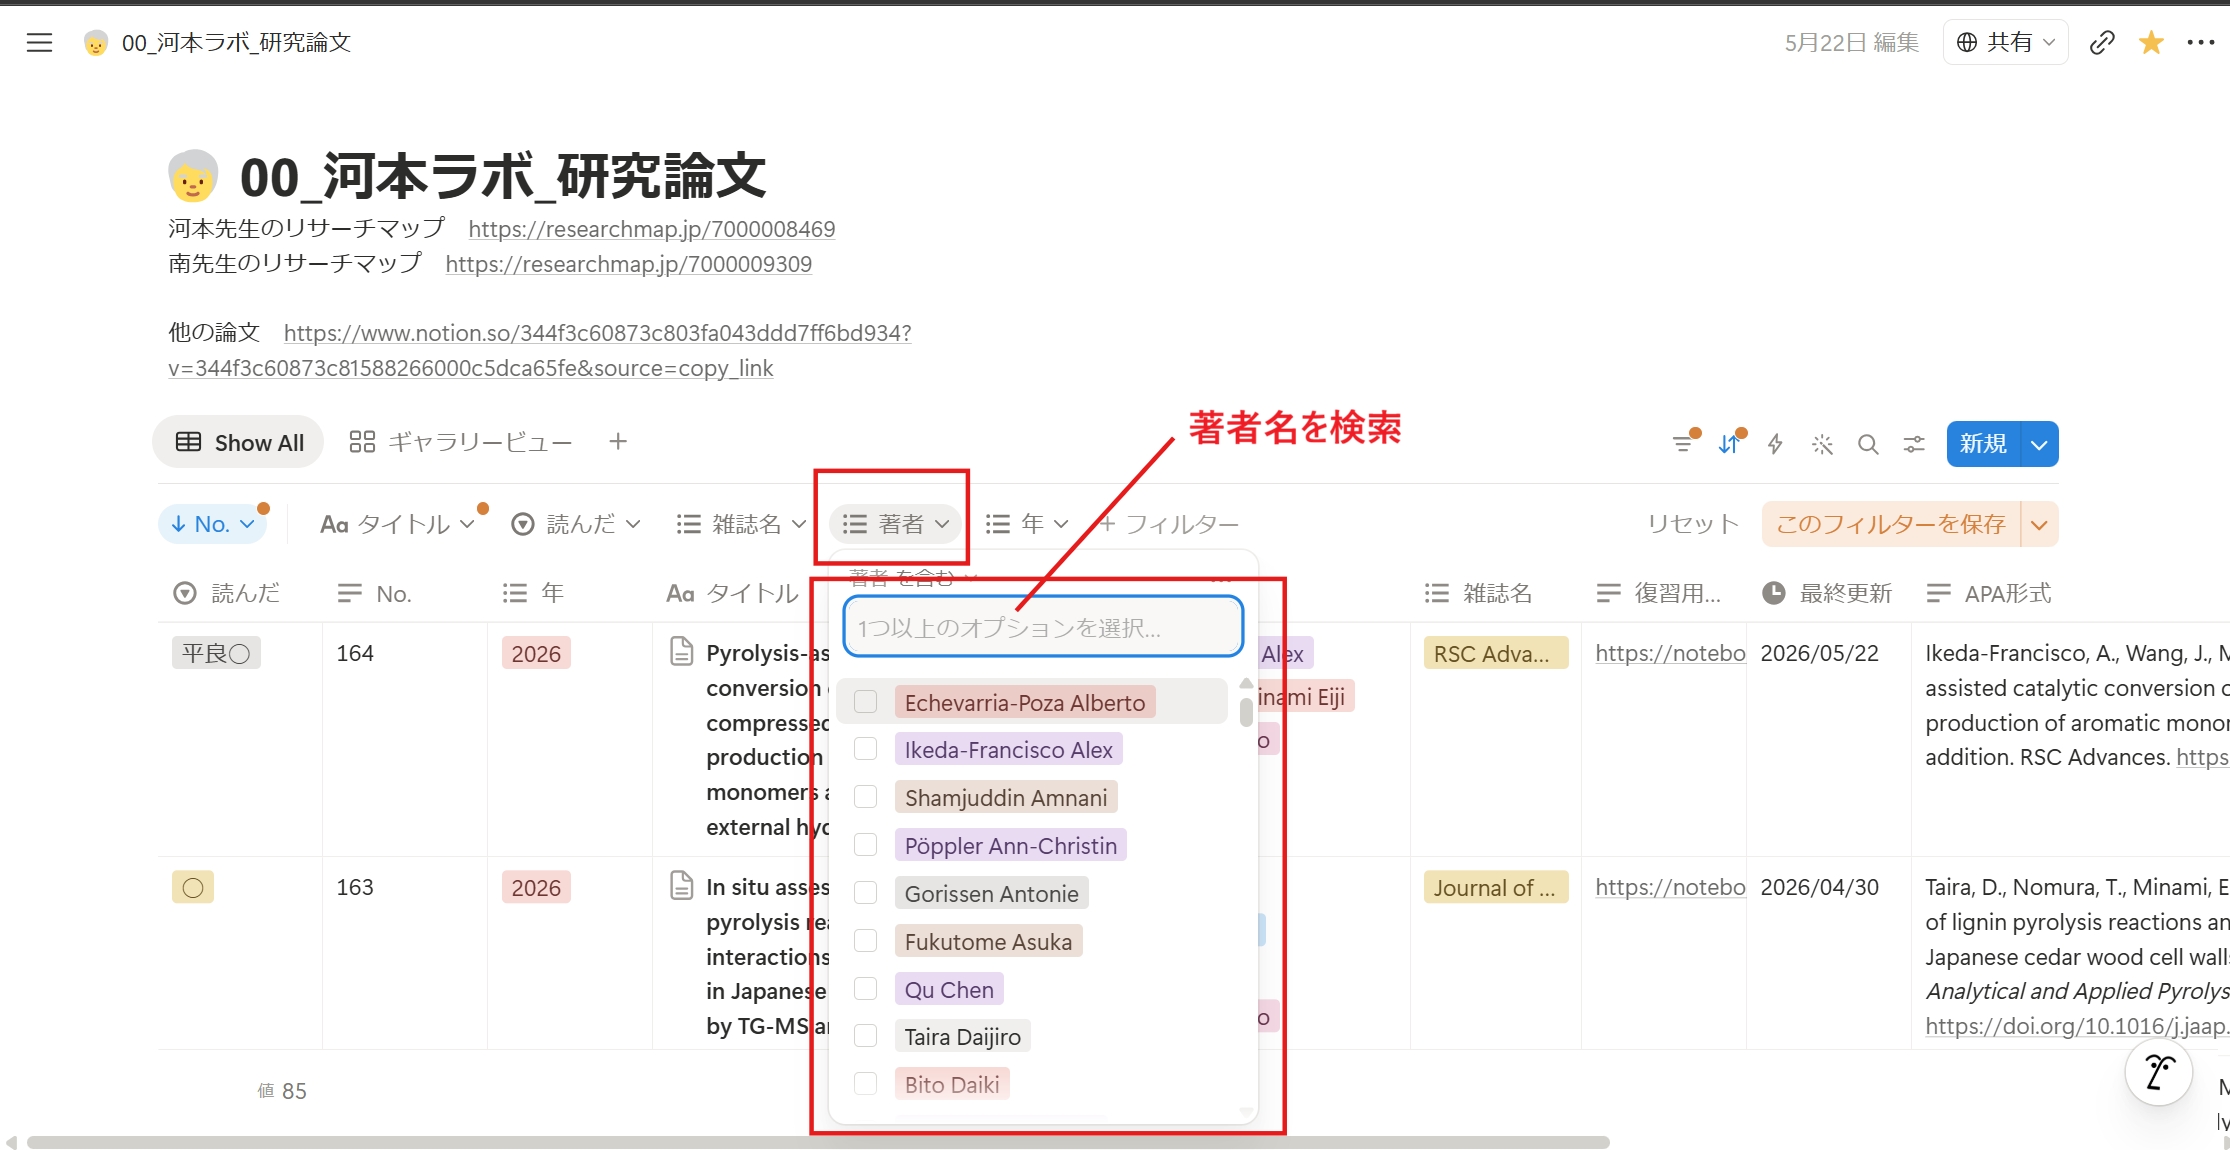
例えば『著者』を選ぶと検索ボックス(赤枠)が出て、著者名で絞り込めます。年・雑誌名でも同様に、目的の論文だけに一覧を絞れます。
-
論文ページ:DOI・PDF(ダウンロード可)・引用
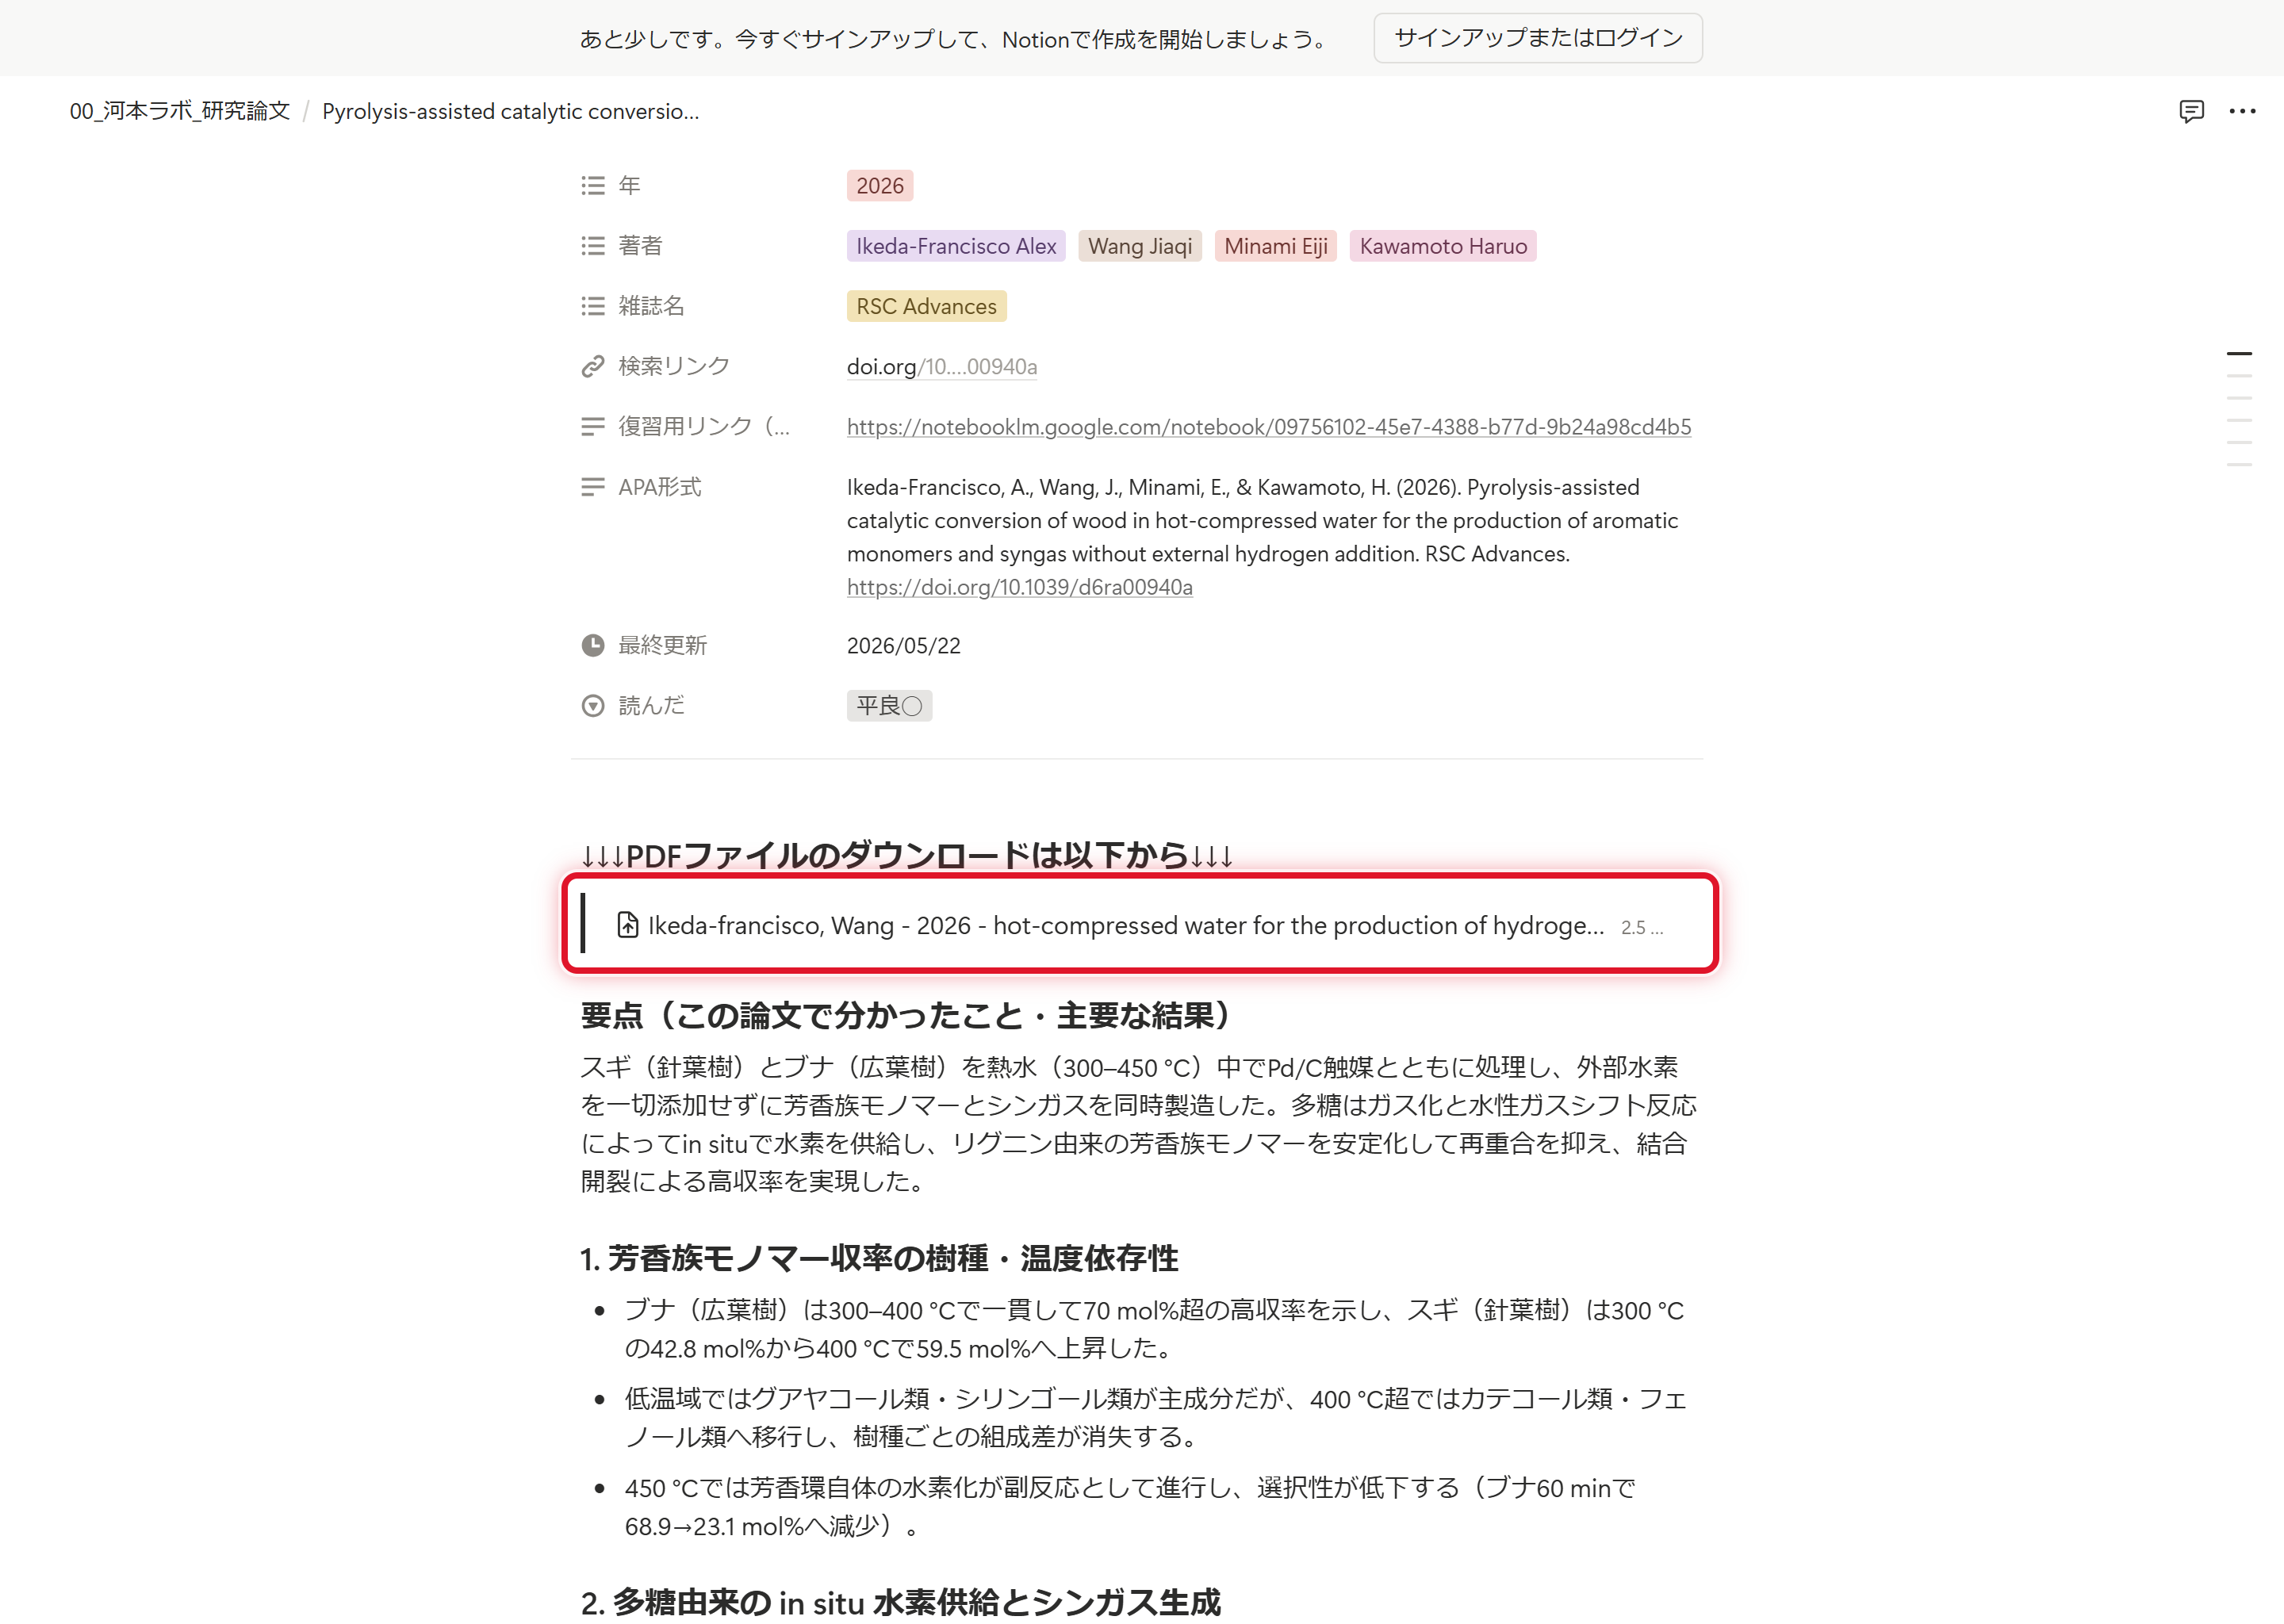
開いた論文ページの上部にプロパティが集約:検索リンク(DOI)で出版社の本文へ、APA形式はそのまま引用にコピー、復習用リンク(NotebookLM)でAI復習へ。本文の先頭には PDF本体(赤枠)が添付されていて、ここからダウンロードできます。例は No.164(RSC Advances 2026・オープンアクセス)。
-
要点と新規性で中身をつかむ
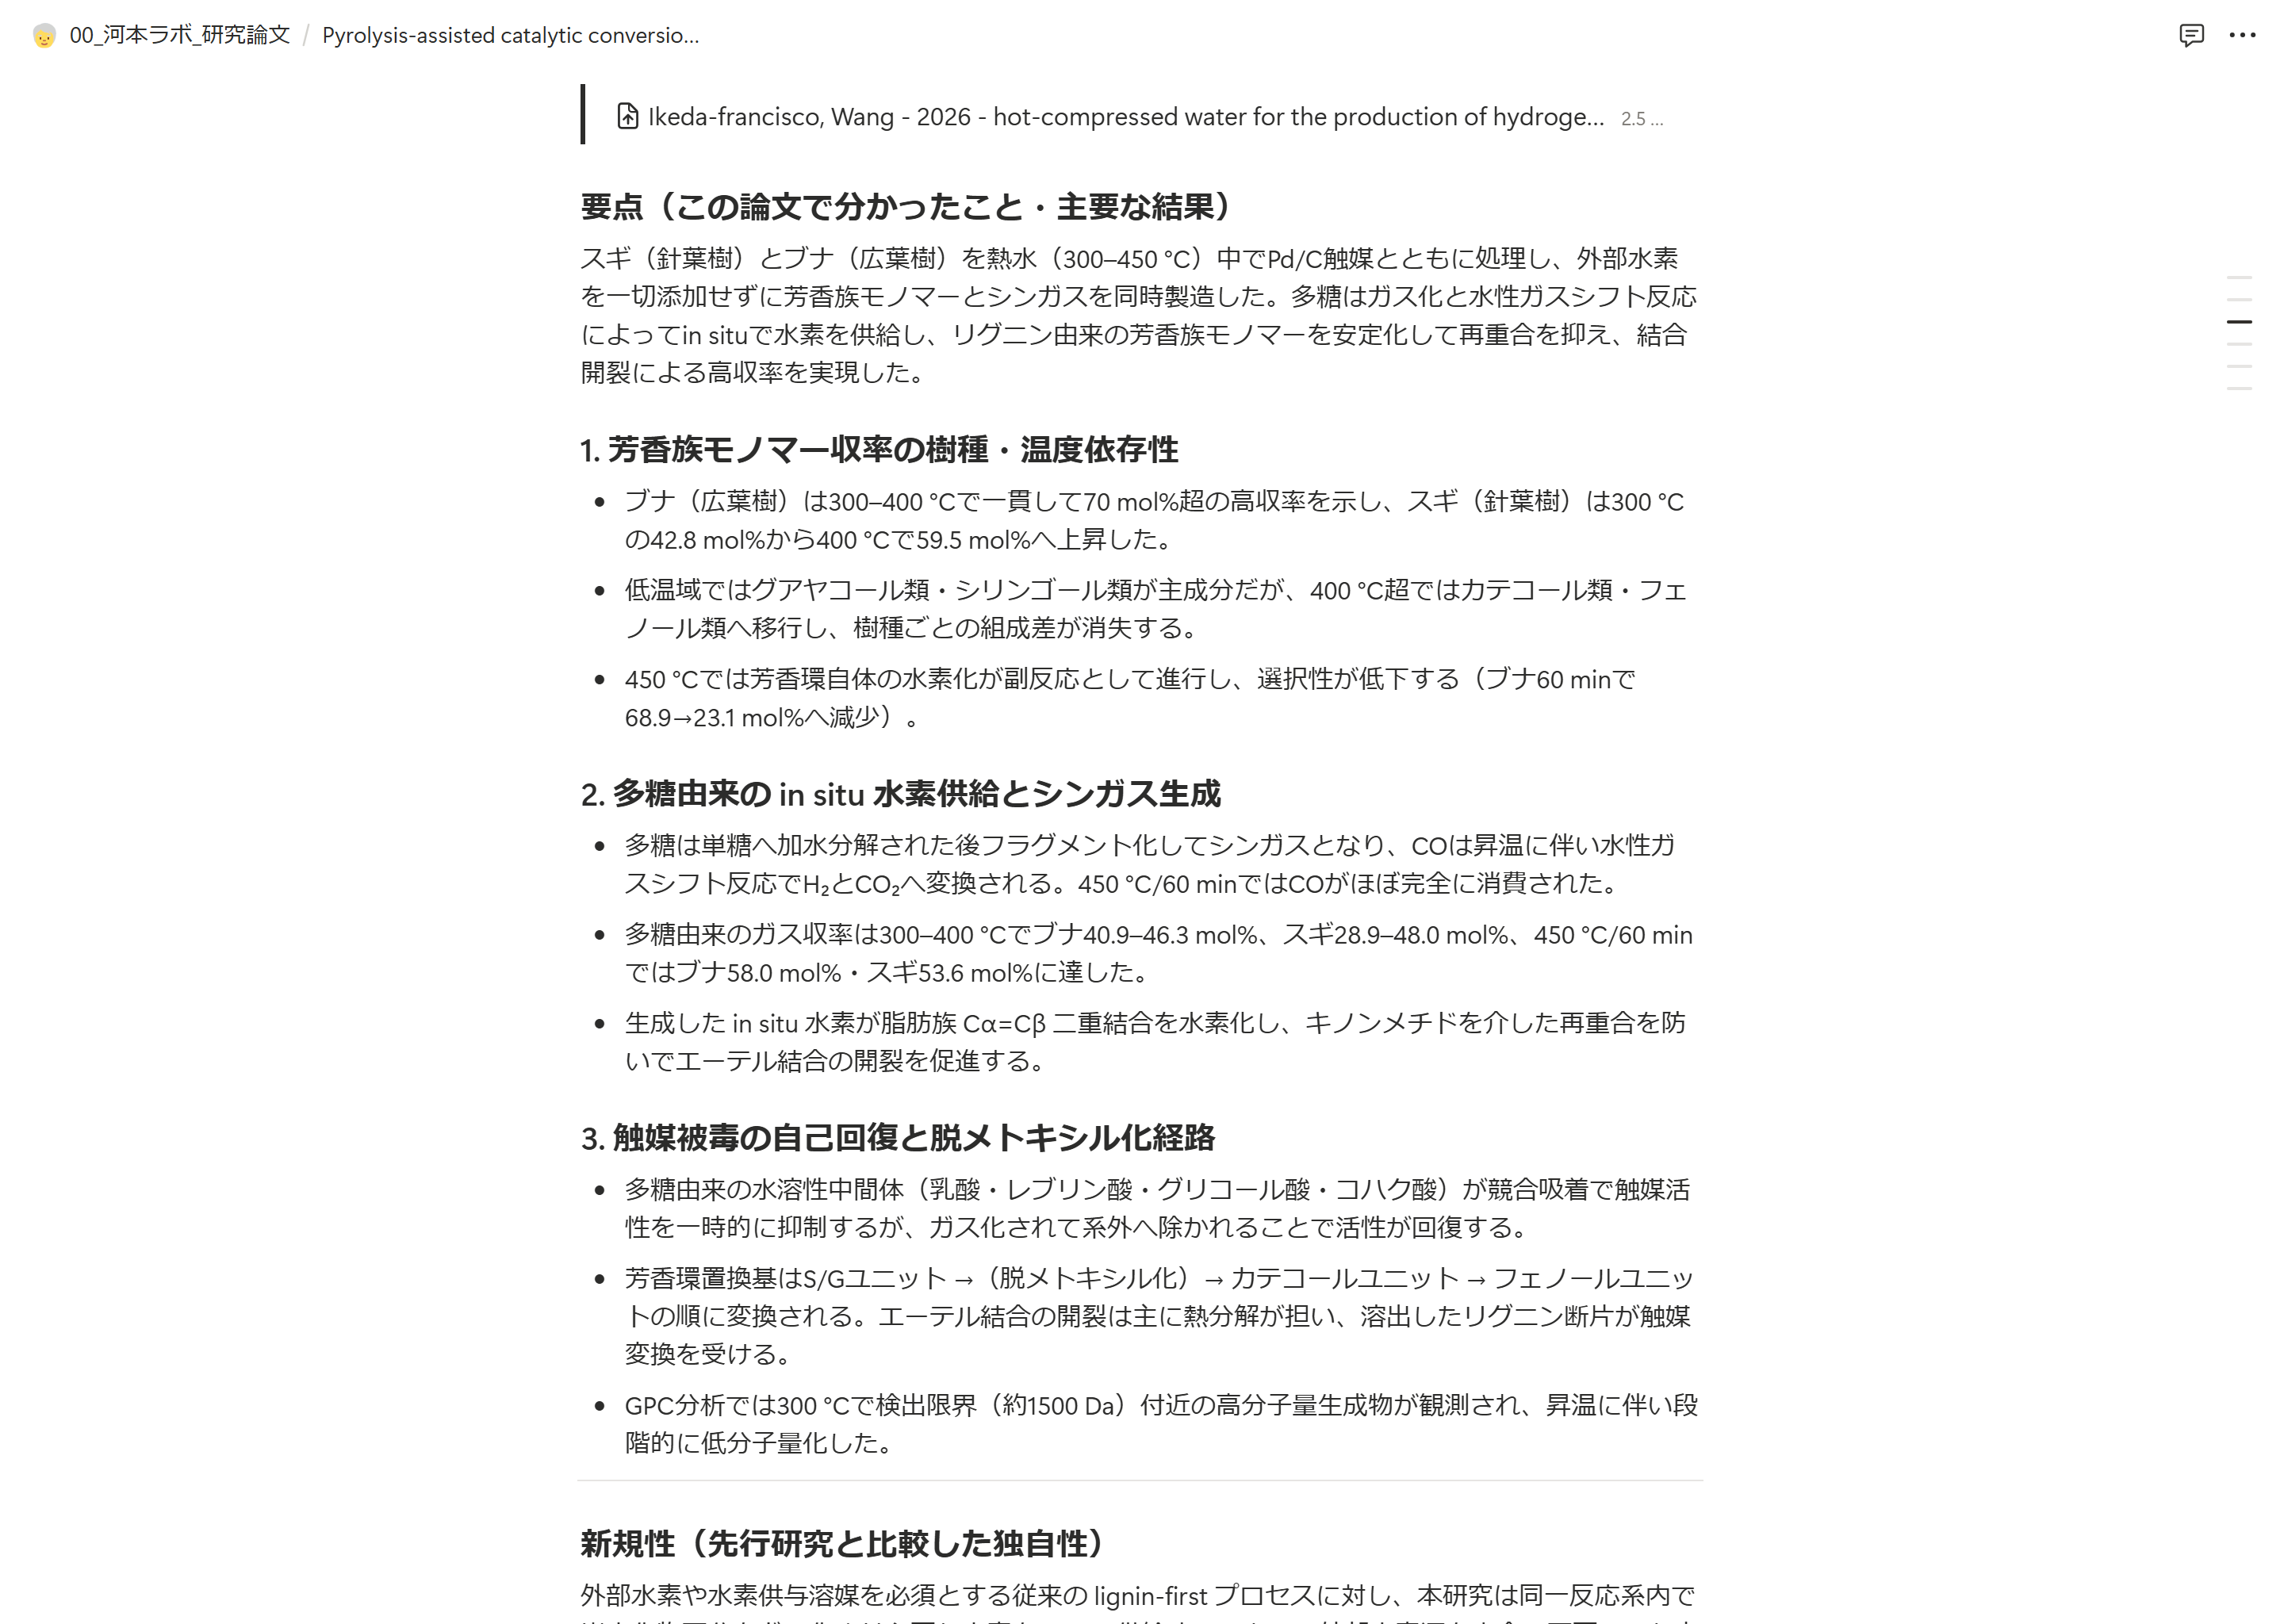
各ページには『要点(主要な結果)』と『新規性(独自性)』のまとめがあります。この論文なら、熱分解+触媒で木材から芳香族モノマー・シンガスを“外部水素なし”で得る話を、温度依存性/多糖由来のin situ水素供給/触媒被毒の自己回復…と箇条書きで把握できます。本文を読む前に要点を先に。
-
図表もページ内で確認
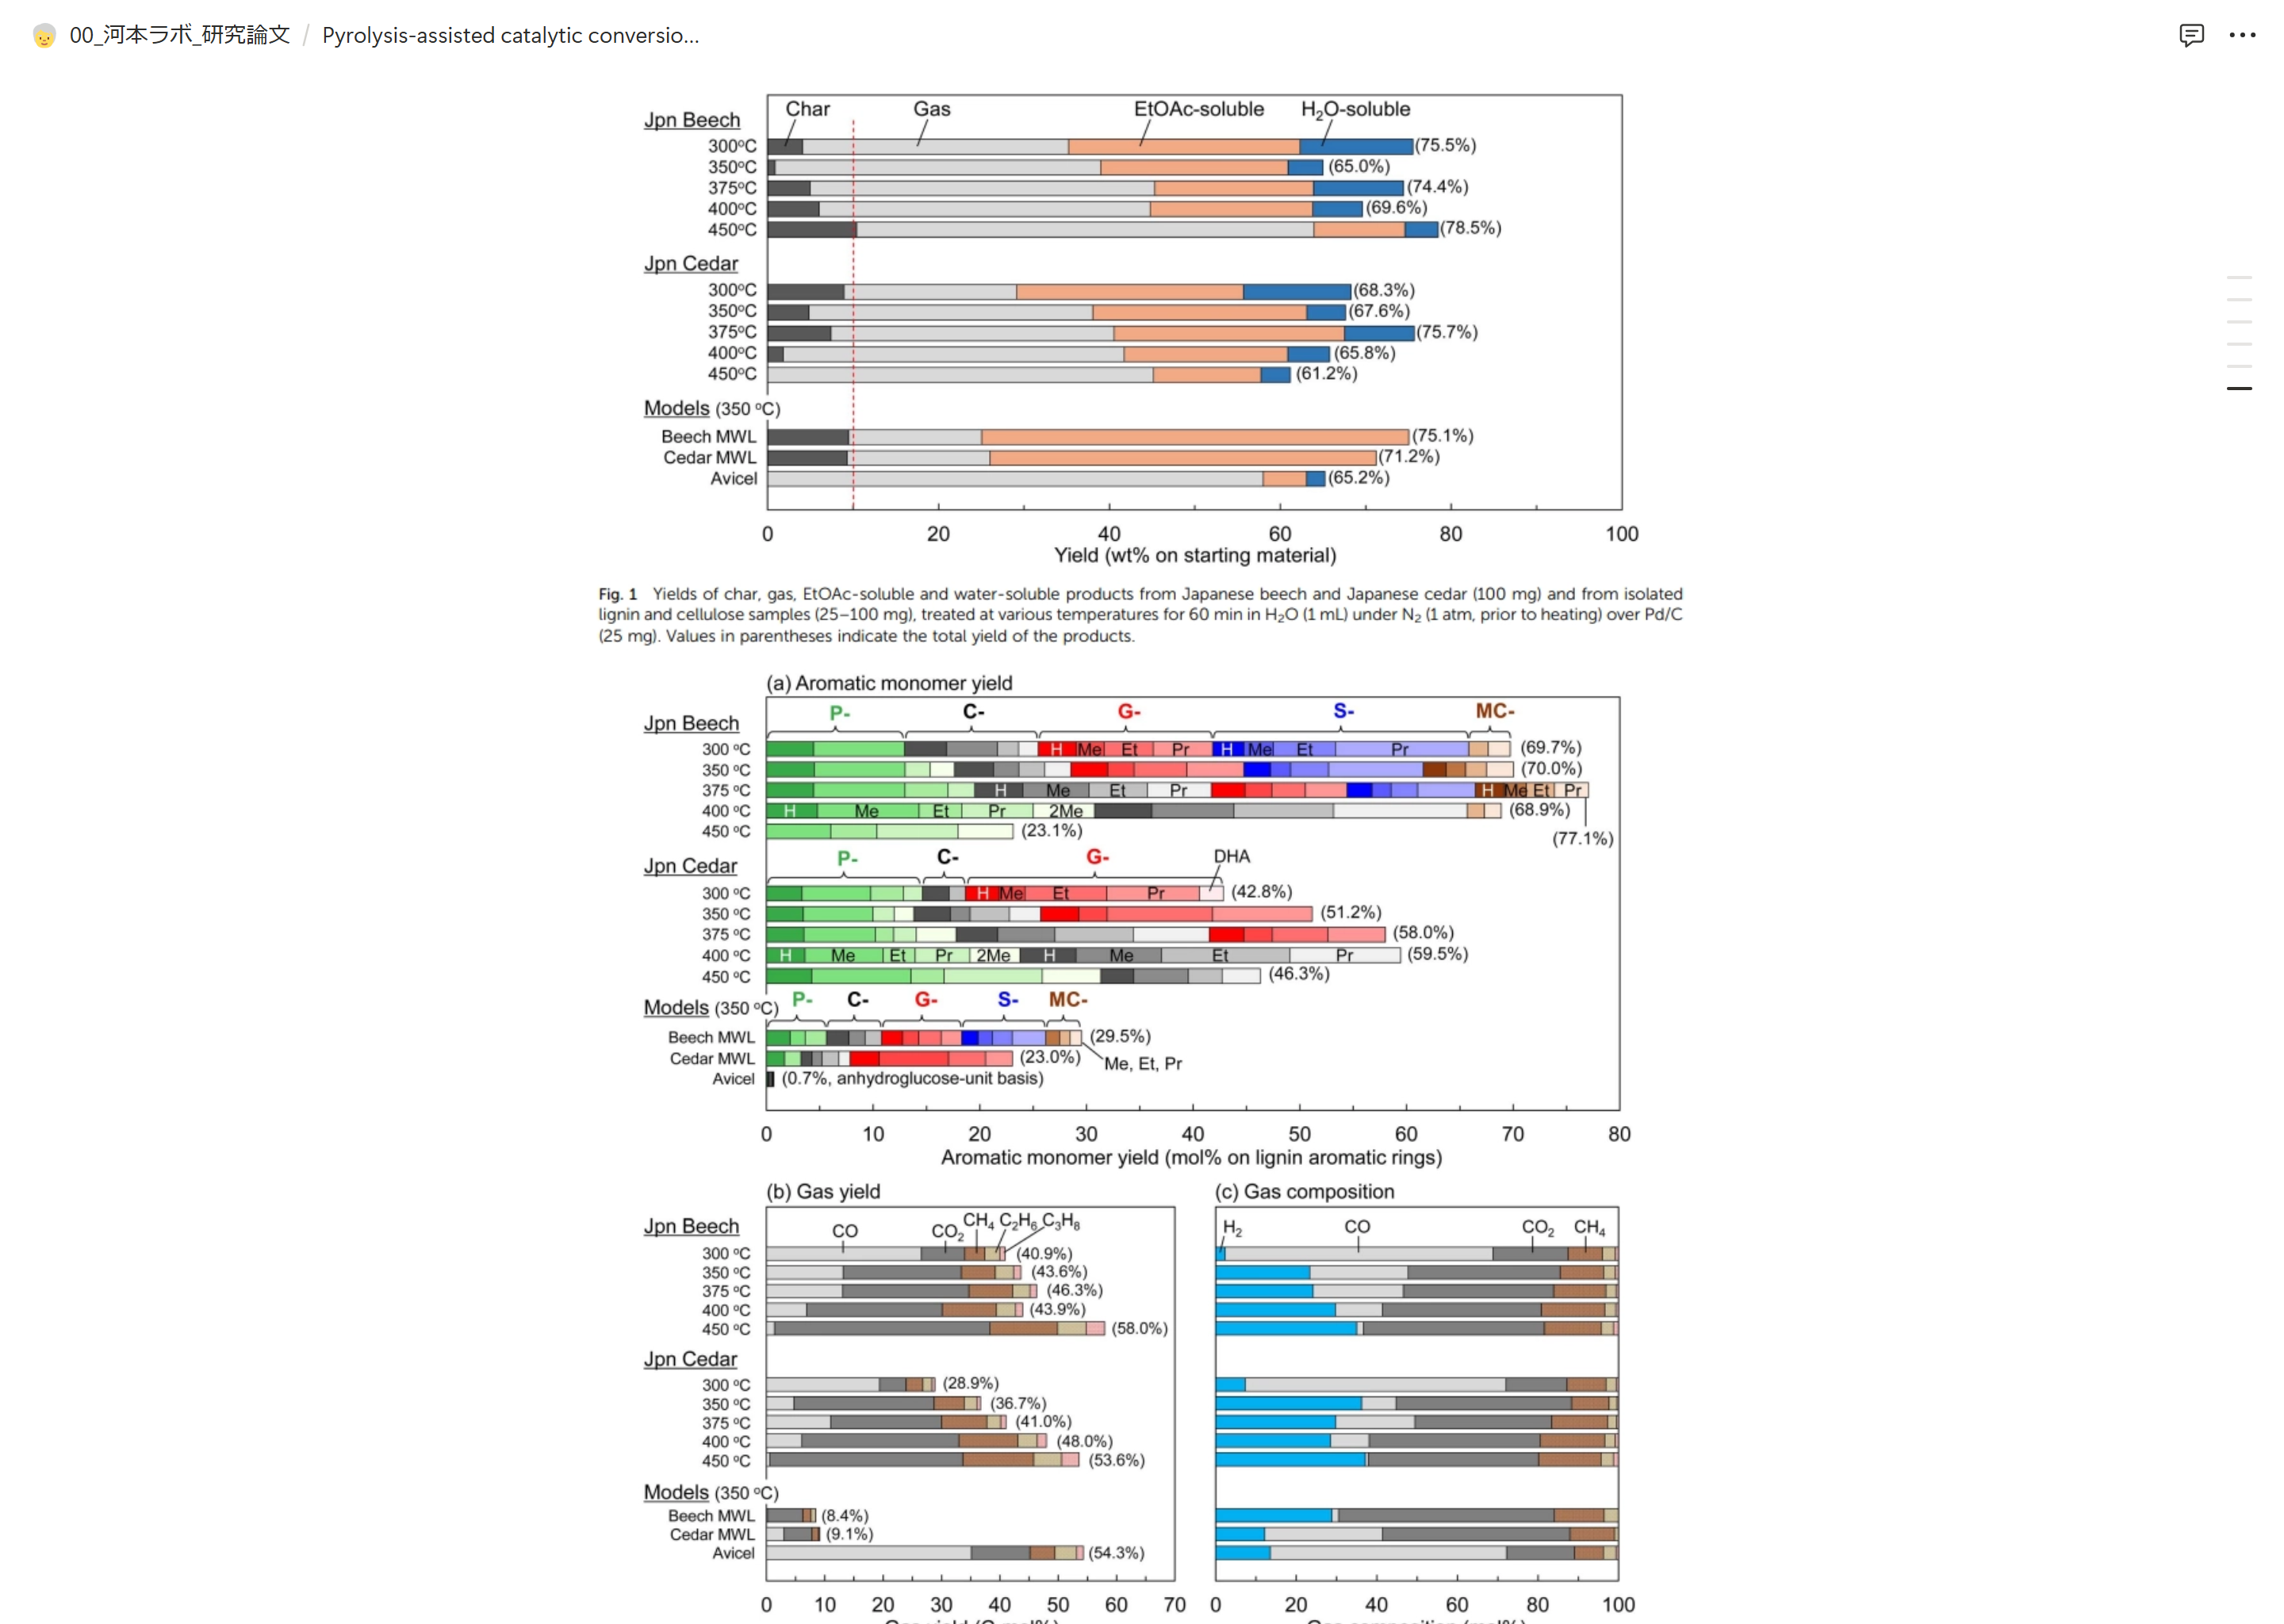
論文の主要な図表もページ内に貼られているので、Notionを離れずに収率・組成などの図まで確認できます。『要点・新規性』はAI要約なので、引用・評価の前に必ずこの原典の図で裏取りを。
-
NotebookLMで復習(全体像)
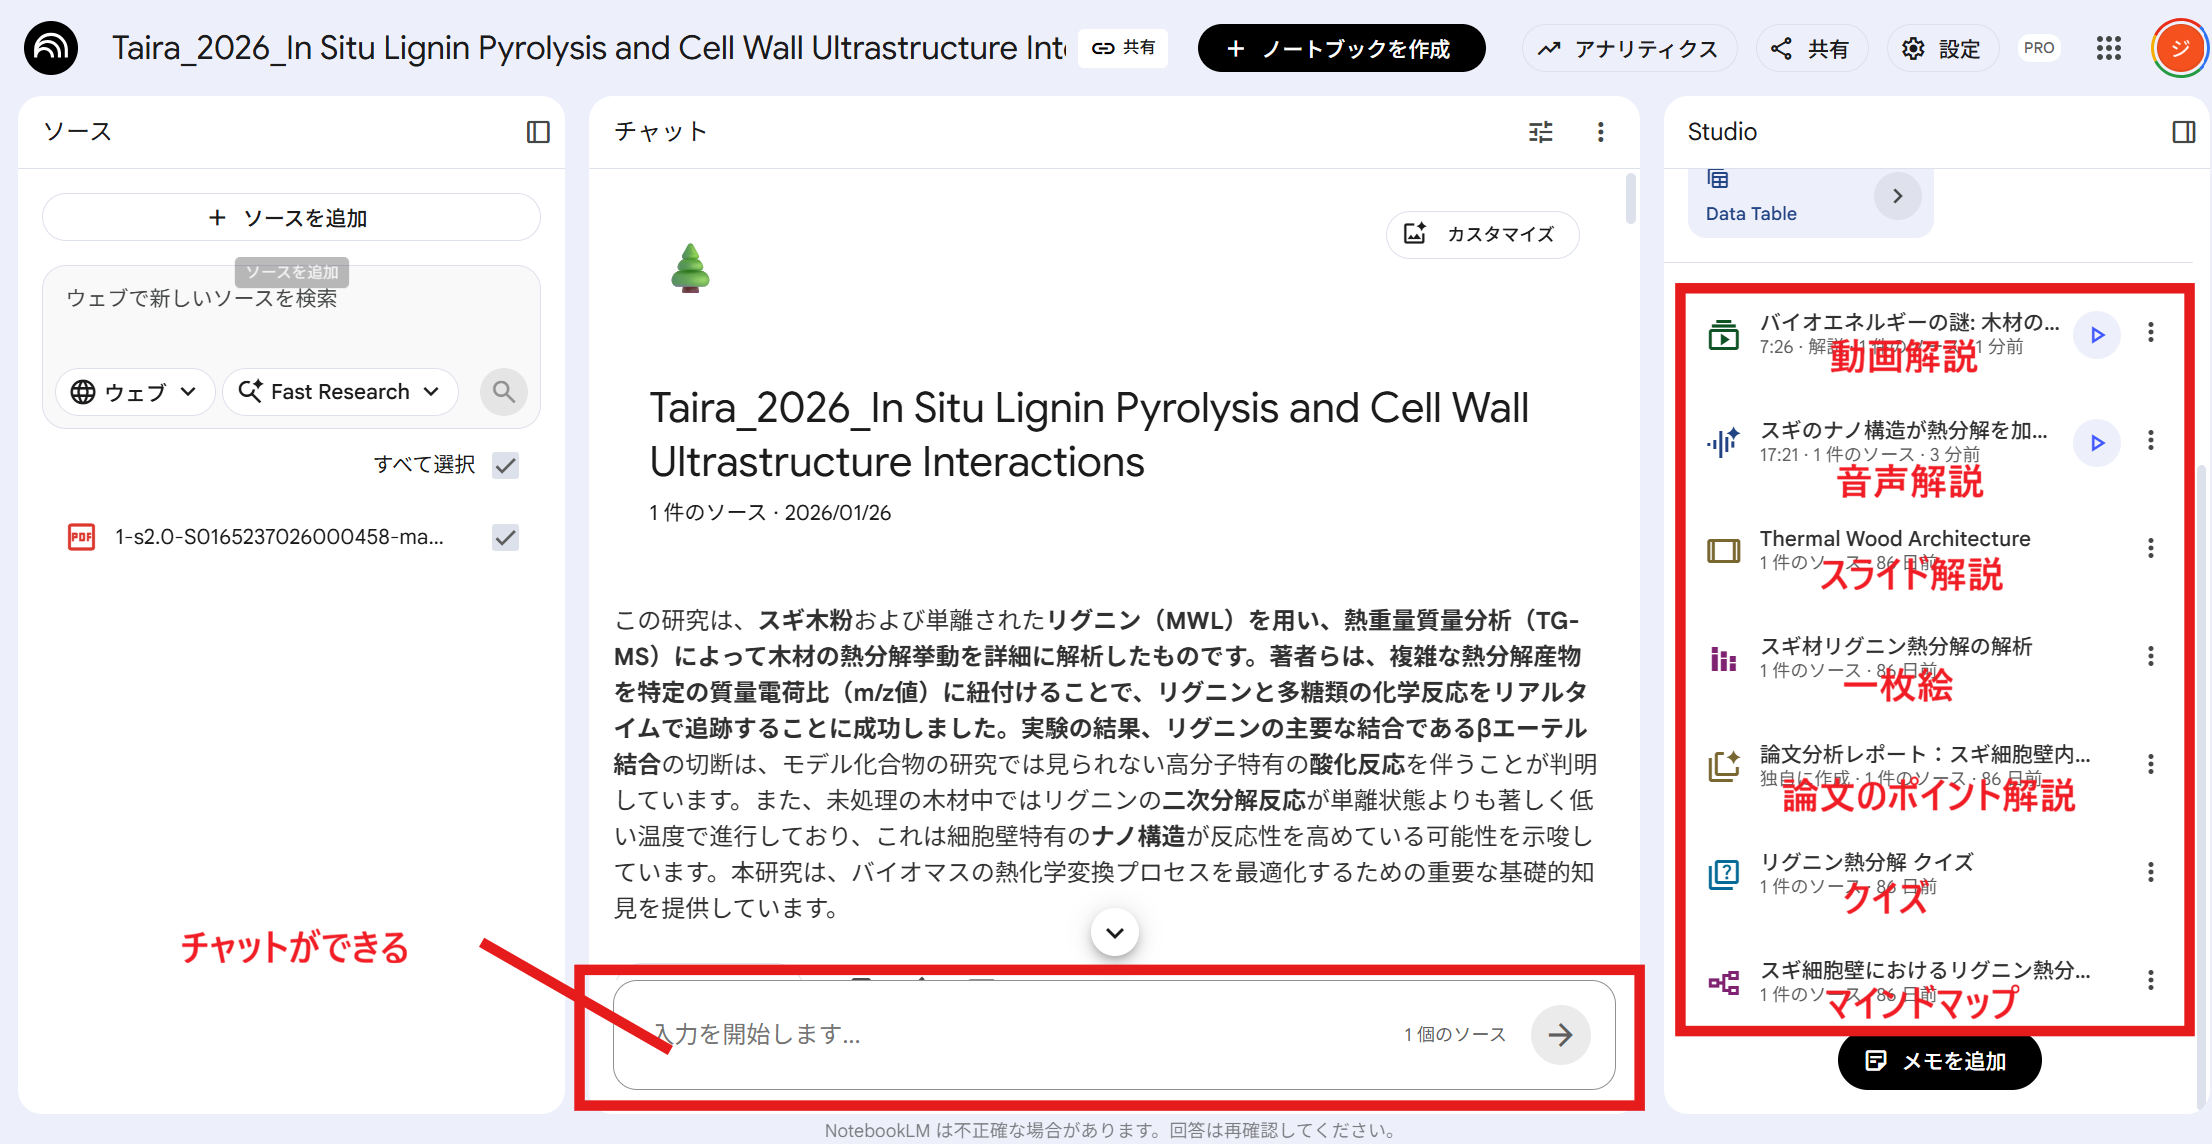
各論文の『復習用リンク』を開くと、その論文専用の NotebookLM が開きます。左にソース(PDF)、中央にチャット(質問できる)、右の Studio から 音声解説・スライド解説・論文のポイント解説・クイズ・マインドマップ を生成できます。
-
AIスライドで要約
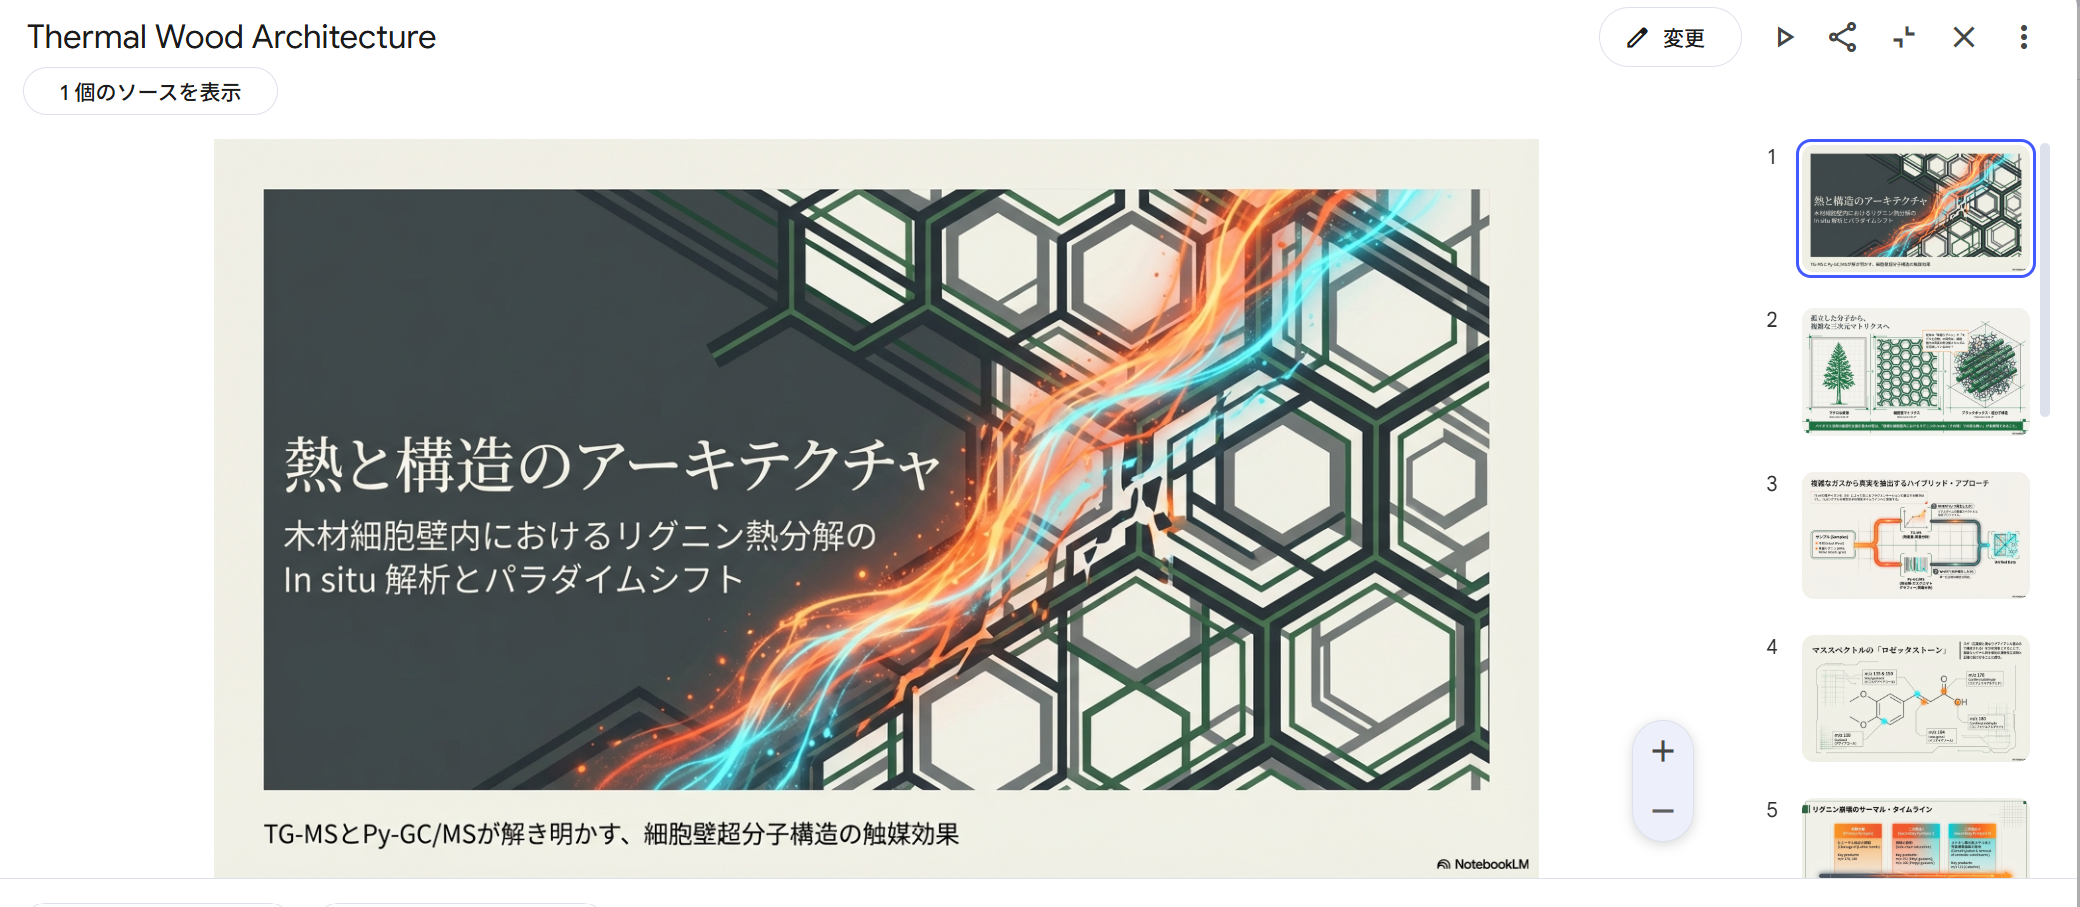
Studioの『スライド解説』で、論文を要約したAIプレゼン(例:「熱と構造のアーキテクチャ」)が自動生成されます。ゼミ発表の下敷きや、全体像の把握に。
-
一枚絵インフォグラフィック
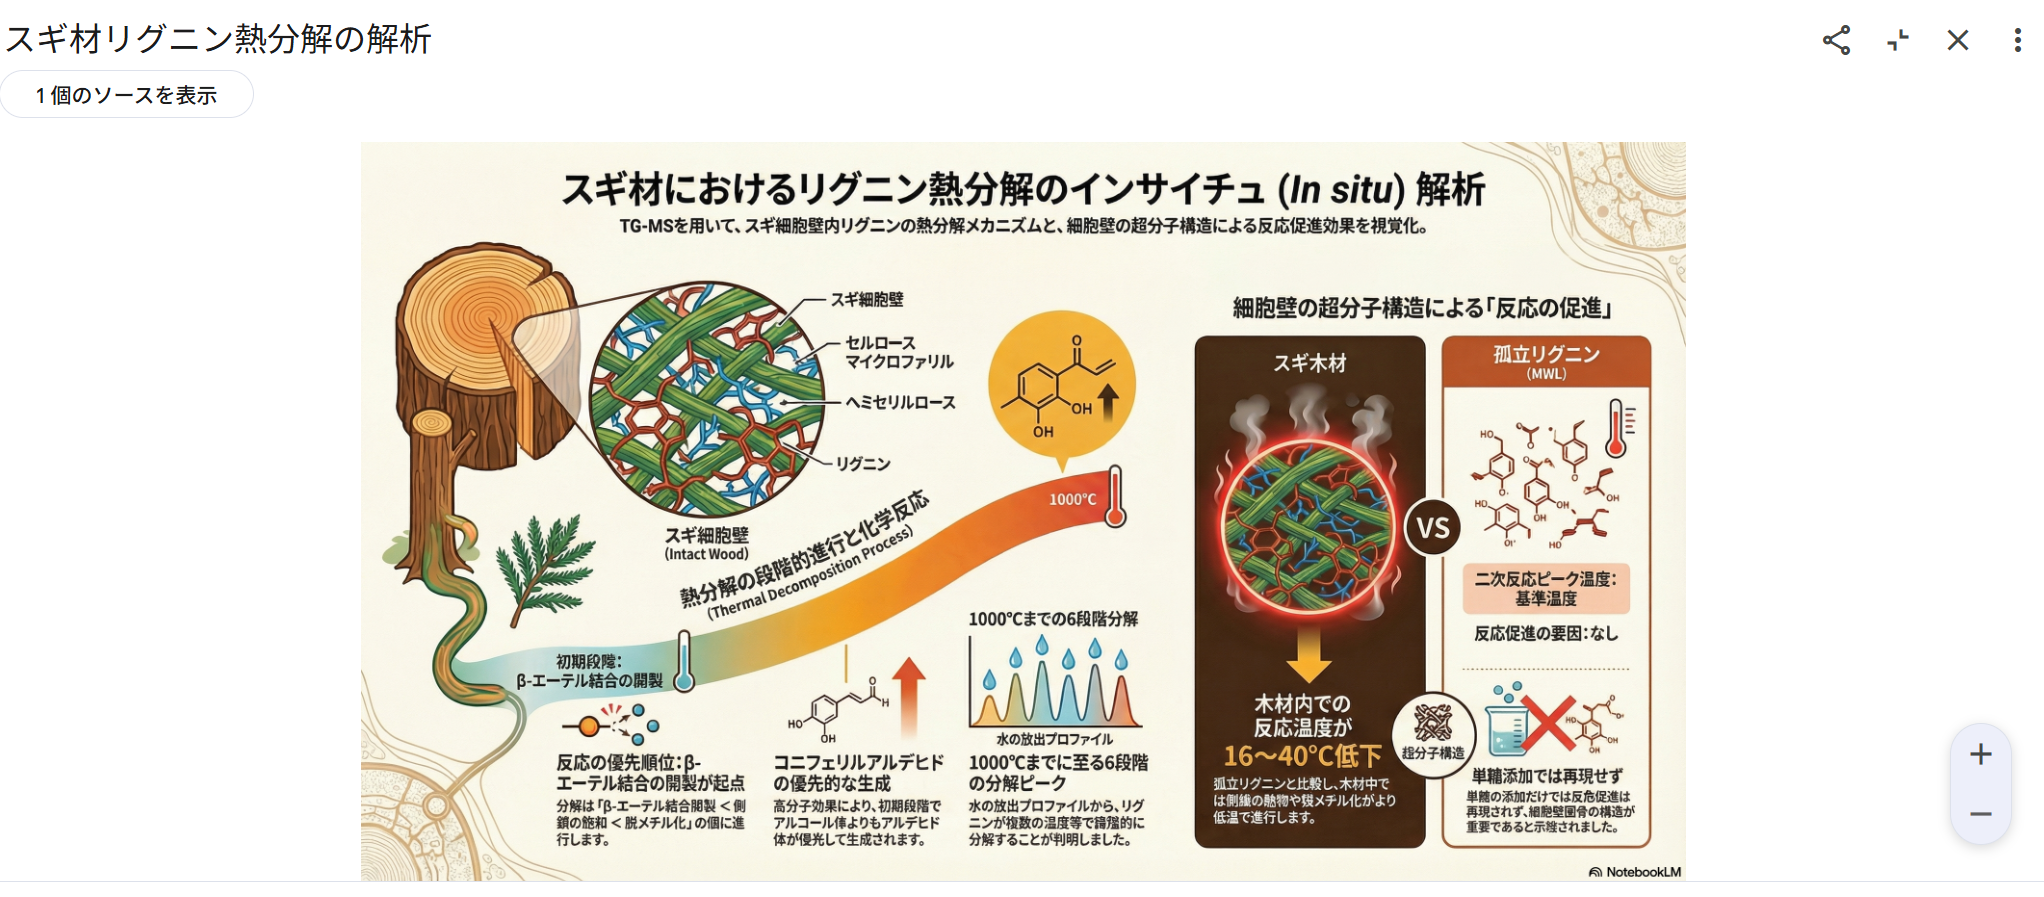
『一枚絵』では、論文の要点を1枚のインフォグラフィックに凝縮(反応経路・細胞壁構造・スギ材 vs 模擬リグニンの比較など)。複雑な内容を一目でつかめます。
-
マインドマップで構造化
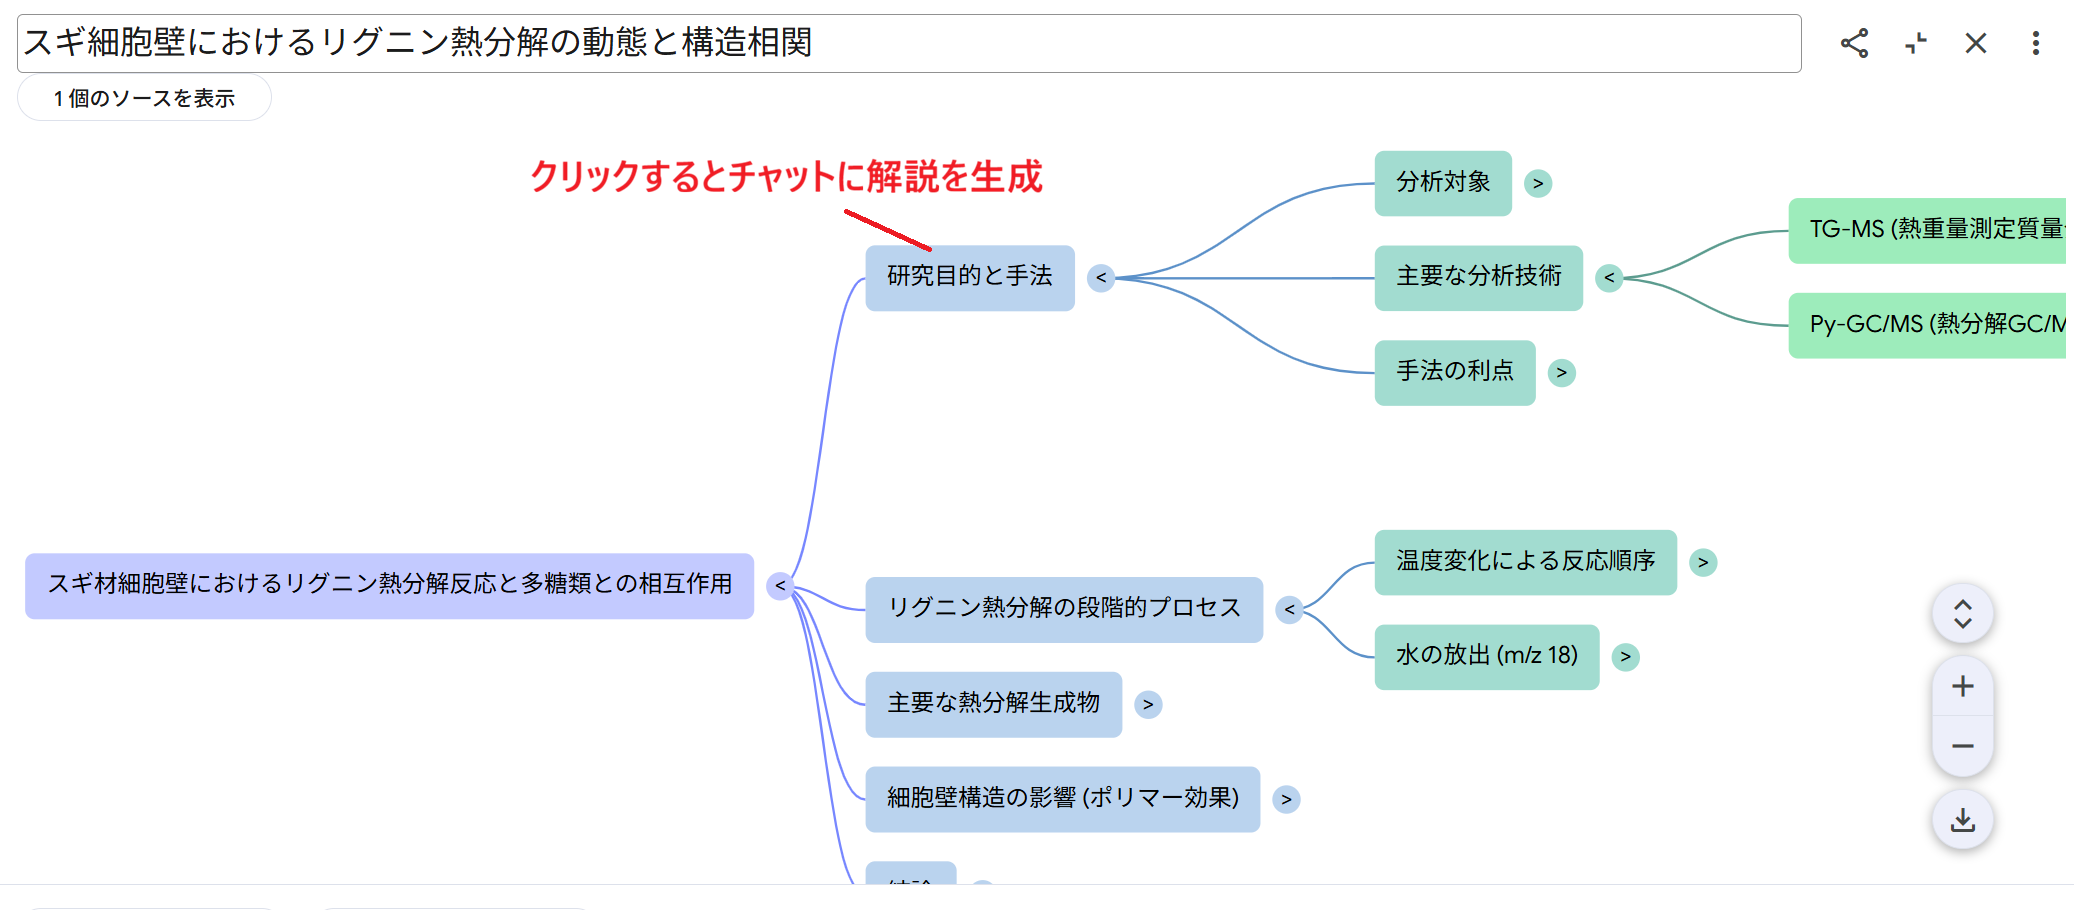
『マインドマップ』は研究目的・手法・反応プロセス・生成物…を枝分かれで整理。ノードをクリックすると、その項目の解説をチャットに生成してくれます。
-
理解度クイズ(問題+ヒント)
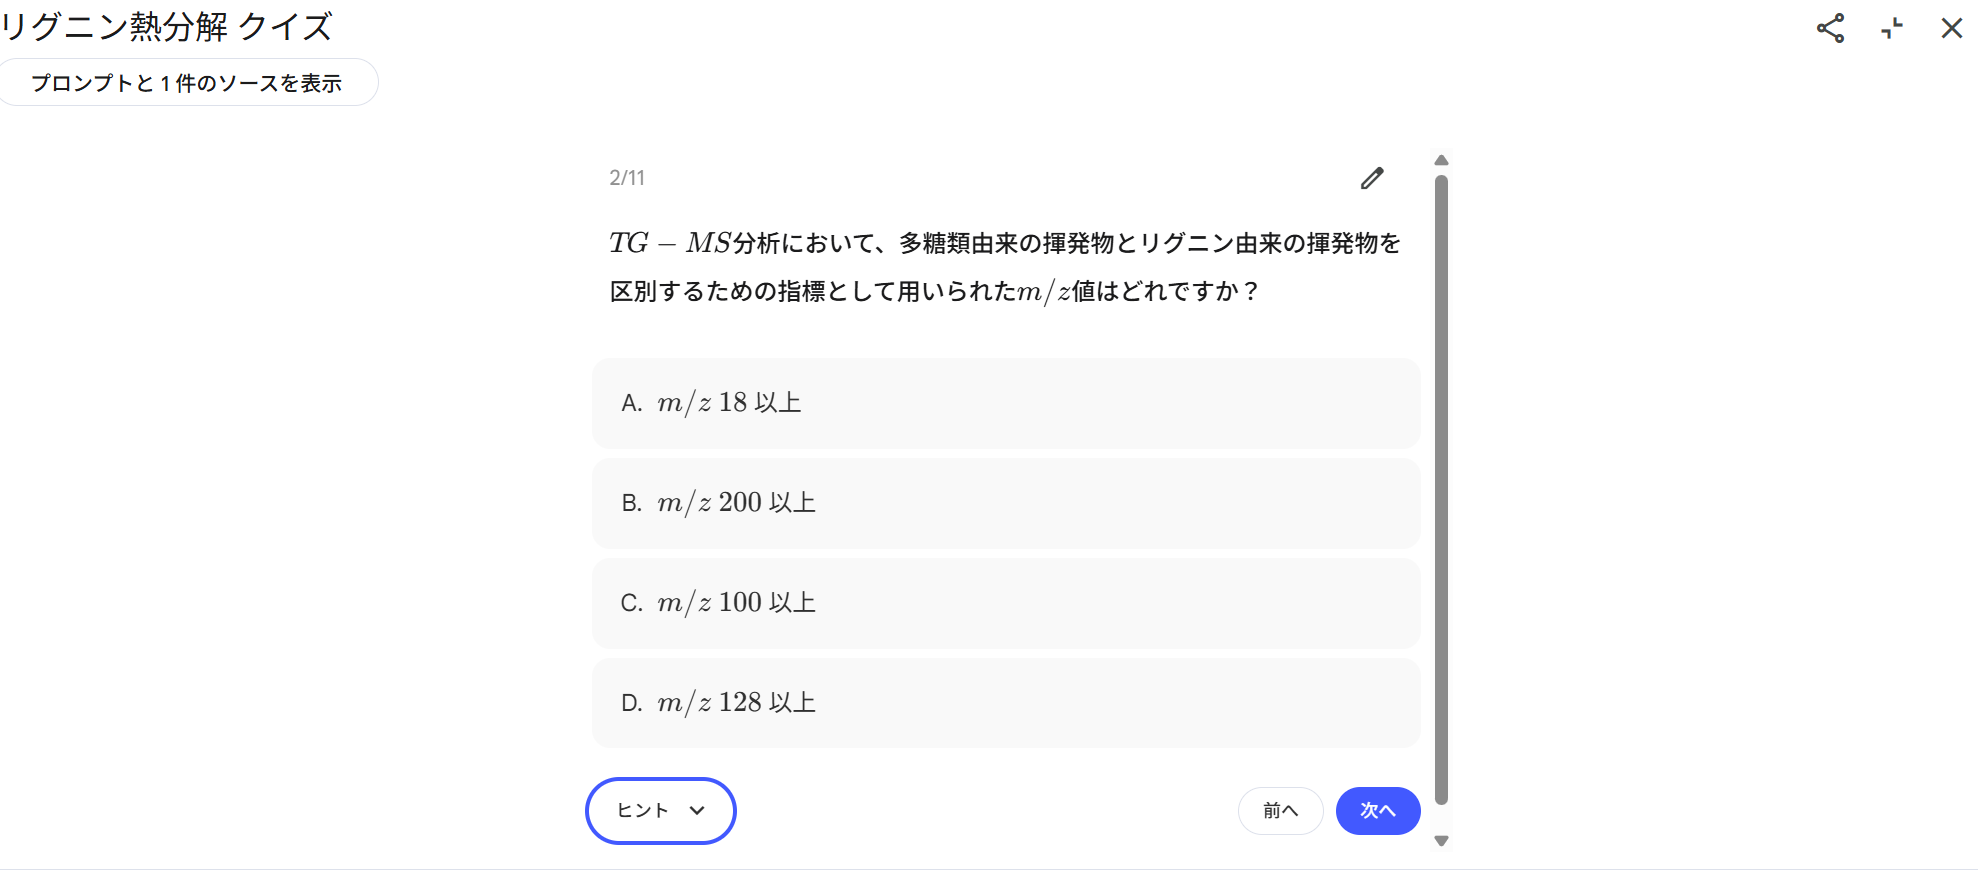
『クイズ』で理解度チェック。論文から多肢選択問題が自動生成され、各問に『ヒント』(赤枠)が付きます(例:TG-MSで多糖類由来とリグニン由来の揮発物を区別するm/z値は?)。
-
解答すると正誤+根拠が出る
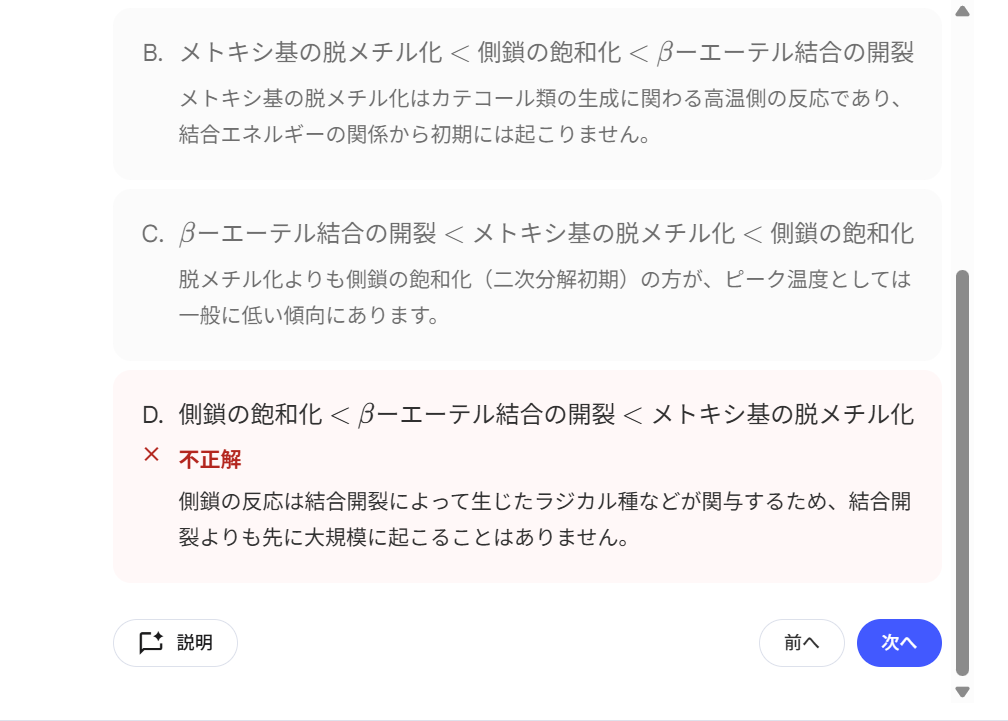
解答すると即座に正誤判定+なぜそうなるかの短い解説が出ます(例:誤答には『側鎖の反応は結合開裂で生じたラジカルが関与するため、先には起こらない』)。左下の『説明』でさらに深掘りできます。
-
『説明』で解説をチャットへ
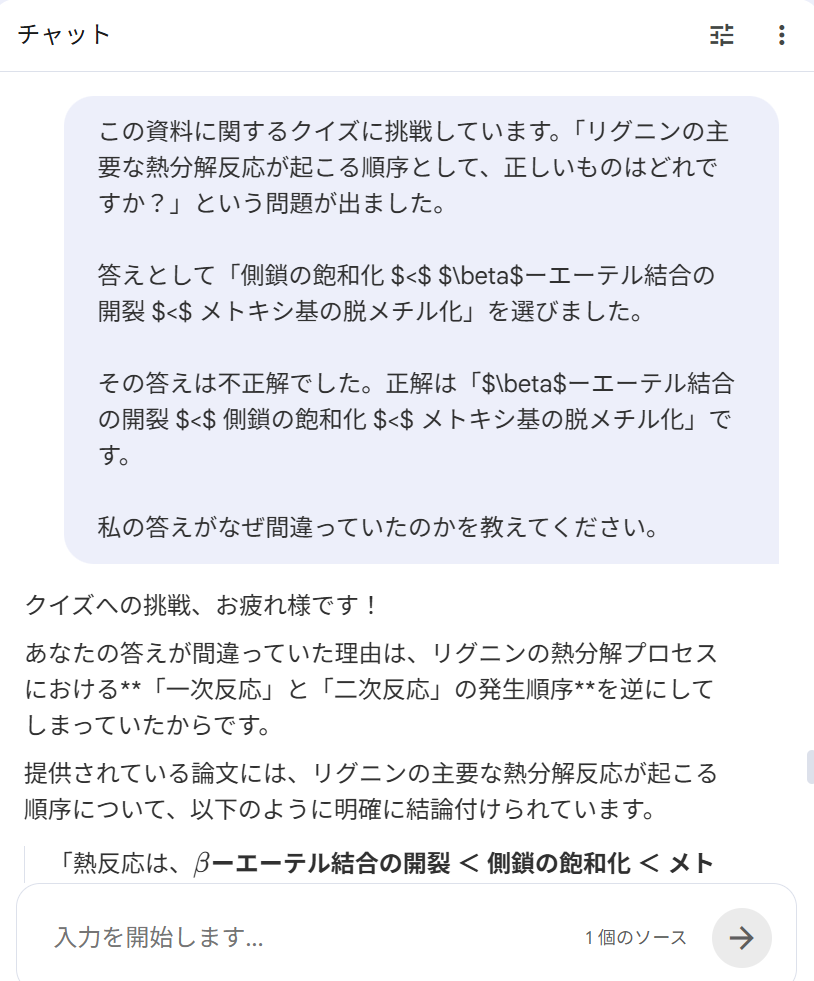
『説明』を押すと、その問題がチャットに送られ、論文を根拠にした詳しい解説が返ってきます。間違えた所をその場で深く理解できます。
-
テスト終了(スコア+学習の継続)
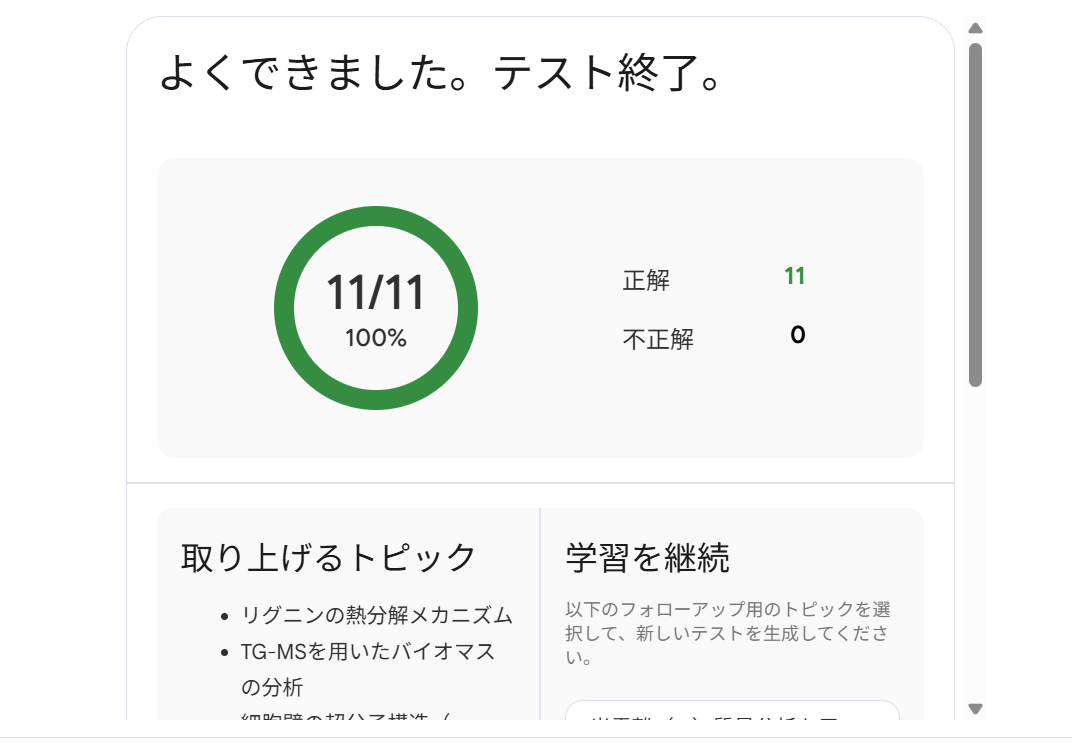
全問終えるとスコアが出ます(例:11/11・100%)。『取り上げるトピック』『学習を継続』から、弱点トピックを選んで新しいテストも作れます。読む→問う→定着までNotebookLMで完結。
仕組みと使った技術
全体の流れ
- Phase 0: ユーザーがResearchMap研究者ID・対象NotionデータベースURL・PDFファイル名フォーマットを事前確認(仕様確定なしで始めると後工程のスキーマ不一致が多発するため必須)
- Phase 1(phase1_scrape_researchmap.py): ResearchMap APIからページネーション対応で全論文を取得(limit=100&start=1)。複数研究者を指定した場合はタイトルベースで重複除去。著者名はname_normalization.pyで末尾カンマ・CAPS姓・日本語順序・イニシャル展開を統一し、Lastname Firstname形式に正規化してpapers.jsonに出力する
- Phase 2(phase2_doi_and_download.py): CrossRef APIにタイトルを投げてDOIを補完(Jaccard類似度0.7未満はスキップ)。次いでUnpaywall APIでOA判定し、pdf_urlが取得できた論文のPDFを年代_タイトル.pdf形式でローカルにダウンロード。ダウンロード成否・pdf_urlをresults.jsonに記録する
- Phase 3(phase3_build_notion_batch.py): results.jsonから全ユニーク著者・ジャーナル・年を抽出してNotion DDL(schema_update.json)を生成。--merge-withオプションで既存スキーマとUNIONして既存データを失わない設計。--keep-only-usedオプションで研究者専用DBは今回使用分だけに絞る。済マークはpdf_urlの有無で判定(is_oa単独では判定しない)し、ページ本文テンプレートにPDFリンクまたはDOI出版社リンクを埋め込む
- Phase 4(Notion MCP経由): まずnotion-update-data-sourceでスキーマにmulti_select値を一括事前登録(未登録のままcreate-pagesするとバリデーションエラーが出るため先行必須)。次にnotion-create-pagesで100件ずつページを作成し、返り値のページIDをpage_ids.jsonに即保存。Agentはmode:bypassPermissionsで起動する
- Phase 4-図表(figure_extractor.py): DOI prefixを判定し、Springer(10.1007/・10.1186/)・Nature(10.1038/)系のみHTMLからcurl+cookieで図画像URLとキャプションを抽出。Notionページ末尾の「## 図表」セクションに追記する。MDPI・Wiley・Elsevier等はCloudflare 403でブロックされるためスキップしログに記録
使った技術
- Python 3(標準ライブラリのみ)
- phase1〜3の全スクリプト。urllib.requestでAPI呼び出し、json/re/argparseで処理。外部ライブラリ依存なし
- ResearchMap API(api.researchmap.jp)
- 研究者IDから論文一覧をJSONで取得。ページネーション対応(limit=100&start=N)
- CrossRef API(api.crossref.org/works)
- 論文タイトルからDOIを検索・補完。Jaccard類似度で誤マッチを除外
- Unpaywall API(api.unpaywall.org/v2)
- DOIからOA判定とPDF直接URLを取得
- Notion MCP(Claude Code統合)
- notion-update-data-source・notion-create-pages・notion-update-pageをClaudeから直接呼び出してスキーマ更新・ページ一括作成・更新を実行
- curl(コマンドライン)
- figure_extractor.pyがSpringer/NatureのHTMLを取得する際にcookie jar付きで使用
- name_normalization.py(自作共通モジュール)
- 著者名の末尾カンマ・CAPS姓・日本語順序・イニシャル展開を処理するlastname-first正規化。known_surnames.json(120姓)・journal_canon.json(23マッピング)の辞書と連携
- Semantic Scholar API(オプション)
- Notionルートが重すぎる際のメタデータ補強代替ルート(APIキー無しだと短時間で429 ban)
実装の工夫
- 著者名正規化を共通モジュール(name_normalization.py)に分離し、phase1・phase3の両方から呼び出す設計。CAPS姓(NONAKA Hiroshi)・日本語逆順(寛 野中)・末尾カンマ・イニシャル展開(R.→Ryota、同姓内で一意な場合のみ)の4パターンに対応
- phase3のスキーマ生成は--merge-withオプションで既存optionsとUNIONする(既存論文の著者名を消さない)と、--keep-only-usedで専用DB向けに今回使用分だけに絞る2モードを実装
- 各フェーズのスクリプトはcache+冪等+resume設計で、中断しても再実行でロスゼロ(_kawamoto_s2_cache.json等でキャッシュ管理)
- notion-create-pagesの返り値ページIDをpage_ids.jsonに即保存する設計。日本語タイトルのNotion検索は不安定なため、後続updateはタイトル検索でなくIDを直接使用する
- 済マークの判定基準をis_oaでなくpdf_urlの存否に統一(is_oa=TrueでもWiley等が403でブロックするケースを経験則から除外)
- figure_extractor.pyはis_supported_doi(doi)とextract_for_doi(doi, cookie_jar)の2関数APIで単発フローとresearchmap-to-notion Skill両方から共通利用できる構造
用語
- Notionデータベース
- 表(テーブル)やギャラリーで情報を管理できるNotionの仕組み。1行=1論文で、列に著者・年・DOI等のプロパティを持つ。
- 要点 / 新規性(AI生成)
- 各論文ページに置いた、AI(Gemini)が清書解説・本文をもとに作った要約。要点=主要な結果、新規性=先行研究と比べた独自性。二次情報なので原典で要確認。
- DOI
- Digital Object Identifier。論文に振られた恒久的なID/URL。『検索リンク』からこのDOIで出版社の本文に確実に辿り着ける。
- APA形式
- 論文の引用書式の一つ。各ページにAPA形式の引用文を用意してあり、そのままコピーして参考文献に使える。
- OA(オープンアクセス)
- 誰でも無料で本文を読める公開形態。OA論文はPDF本体をページに添付できる(非OAはDOIリンクのみ)。
- NotebookLM
- Googleの資料ベースAIノート。各論文の『復習用リンク』から、その論文を読み込ませた専用ノートで、チャットQ&A・スライド・一枚絵・マインドマップ・クイズを生成して復習できる(閲覧にはGoogleログインが必要)。